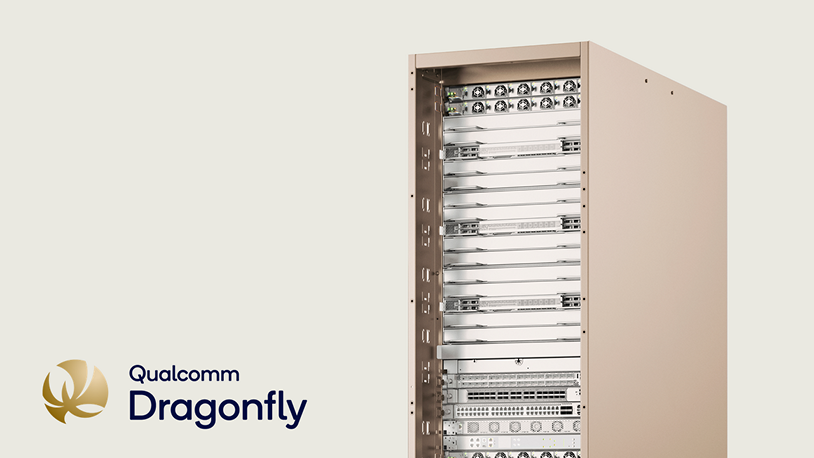
Qualcomm a annoncé que la première génération de son silicium High Bandwidth Compute (HBC), la technologie qui place le calcul à côté de la mémoire pour accélérer l’inférence d’IA, a passé la validation matérielle dans son laboratoire de San Diego. Selon l’entreprise, les tests ont couvert l’ensemble du chemin de lecture et d’écriture de la mémoire et les calculs proches de celle-ci, avec des dimensions représentatives de la production. C’est l’étape préalable à son intégration dans Dragonfly AI250, l’accélérateur d’inférence dont elle espère avoir des échantillons au premier semestre 2027.
Les points clés du silicium HBC de Qualcomm en 20 secondes
- Ce qui s’est passé : le premier silicium HBC a passé la validation matérielle.
- Chiffres : Qualcomm estime une bande passante 18 fois supérieure à la LPDDR5X et plus de cinq fois supérieure par watt à la HBM4.
- Étape suivante : Dragonfly AI250, avec des échantillons prévus au premier semestre 2027.
L’annonce est signée Rashid Attar, vice-président senior de l’ingénierie de Qualcomm Technologies, sur le blog d’entreprise OnQ. Qualcomm ne publie cette fois ni chiffres absolus de bande passante ni de consommation, mais deux comparaisons relatives, qu’elle accompagne d’une mise en garde : ce sont des estimations propres, établies à partir de résultats mesurés sur le silicium de première génération, normalisés aux conditions de fonctionnement cibles et comparés aux spécifications publiées de produits concurrents. Les performances finales, ajoute-t-elle, peuvent varier selon l’implémentation, la charge de travail et la configuration du système.
Ce que Qualcomm a mesuré en laboratoire
Le point de départ est un problème bien connu de l’inférence des modèles de langage : pour générer chaque token, il faut amener les données du modèle de la mémoire jusqu’aux unités de calcul, et à l’échelle d’un centre de données ce mouvement pèse sur la latence, la consommation et le coût total. HBC cherche à s’attaquer à ce goulet d’étranglement en rapprochant le calcul de la mémoire, de sorte que moins de données circulent et que la bande passante effective augmente.
Pour la validation, l’équipe d’ingénierie de Qualcomm a utilisé des équipements de test automatisés standard de l’industrie et exécuté des calculs avec des poids et des activations aléatoires. De là viennent les deux chiffres publiés : une bande passante mémoire effective, mesurée comme performance relative le long du chemin mémoire, 18 fois supérieure à celle de la LPDDR5X, et une bande passante par watt plus de cinq fois supérieure à celle de la HBM4, la mémoire à haute bande passante qu’utilisent les accélérateurs haut de gamme. Aucun des deux ne provient d’un test avec un modèle d’IA réel ni d’une comparaison mesurée avec du matériel concurrent, mais avec ses spécifications.
L’entreprise détaille en outre l’état du programme. Elle dit avoir développé et caractérisé, avec des partenaires de fonderie et d’assemblage qu’elle ne nomme pas, un procédé de liaison wafer-à-wafer sur plusieurs générations technologiques, et avoir intégré de la redondance et de la réaffectation pour contourner les défauts de mémoire. Elle affirme aussi qu’un produit pour centres de données a déjà achevé son tape-out et que le démarrage initial d’une base logique avec des couches de DRAM liées au-dessus donne déjà un rendement de fabrication. En août, TrendForce avait publié que Samsung et SK hynix seraient les partenaires mémoire de HBC et que TSMC visait un rôle dans l’encapsulation, ce que Qualcomm n’a pas confirmé dans cette annonce.
De la promesse de juin au silicium de novembre
HBC n’est pas nouveau en tant qu’annonce. Qualcomm l’a présenté lors de son Investor Day de juin, dans le portefeuille Dragonfly avec lequel elle tente d’entrer dans le centre de données pour l’IA agentique. Elle avait alors parlé de 133 TB/s par carte pour la première génération, d’une bande passante effective 18 fois supérieure à celle de l’AI200, son accélérateur basé sur la LPDDR5X, et de six fois plus de bande passante par watt que la HBM. Pour la deuxième génération, dans l’AI300, elle avait promis 54 fois la bande passante effective de l’AI200, avec des échantillons en 2028.
La nouveauté d’aujourd’hui est que ces chiffres ne proviennent plus seulement de conceptions et de véhicules de test, mais de silicium physique. Le facteur 18 face à la LPDDR5X coïncide avec ce qui avait été annoncé en juin. La comparaison par watt change de forme : en juin, elle était de six fois face à la HBM, et elle est maintenant de plus de cinq fois face à la HBM4, une référence plus exigeante ; les deux ne sont donc pas directement comparables. Le calendrier est lui aussi maintenu : Dragonfly AI250 amènera HBC dans un accélérateur complet et dans Dragonfly Rack, la solution rack de Qualcomm, avec des échantillons au premier semestre 2027. Qualcomm la vend aux hyperscalers, aux fournisseurs de cloud et aux entreprises avec pour argument d’améliorer les tokens par dollar et par watt grâce à une architecture de rack ouverte et désagrégée.
Ce qu’il reste à démontrer
Valider le silicium en laboratoire n’équivaut pas à avoir un produit en service. Qualcomm doit encore intégrer HBC dans l’AI250, le fabriquer avec des rendements acceptables et démontrer que les avantages de bande passante se traduisent en plus de tokens par watt avec des modèles réels et dans des racks complets. Quand l’AI250 arrivera chez les clients, les comparaisons se feront avec les produits que NVIDIA et AMD auront sur le marché en 2027, et non avec les spécifications publiées aujourd’hui.
L’entreprise appuie sa crédibilité sur plus d’une décennie de travaux sur la liaison directe de DRAM sur la logique, l’encapsulation avancée et l’empilement 3D, ainsi que sur sa participation aux normes LPDDR du JEDEC. Dans l’activité centres de données, son client de référence public est pour l’instant Meta, qui a choisi son CPU Dragonfly. Elle n’a annoncé aucun client pour l’AI250.
Questions fréquentes
Qu’est-ce que Qualcomm HBC ?
High Bandwidth Compute est une architecture de Qualcomm qui assemble des couches de DRAM sur une base logique et rapproche le calcul de la mémoire pour réduire les mouvements de données lors de l’inférence d’IA.
Quelles performances HBC promet-il ?
Qualcomm estime une bande passante effective 18 fois supérieure à celle de la LPDDR5X et plus de cinq fois plus de bande passante par watt que la HBM4, en comparant avec des spécifications publiées de la concurrence.
Quand arrivera-t-il sur le marché ?
HBC arrivera intégré à l’accélérateur Dragonfly AI250, dont Qualcomm espère avoir des échantillons au premier semestre 2027.
Source : Qualcomm