Samsung verrouille 70 % de sa mémoire jusqu’en 2031 sous la pression de l’IA
Samsung Electronics aurait engagé environ 70 % de sa capacité de production de mémoire dans des accords d’approvisionnement à long terme courant jusqu’en 2031. Le chiffre, rapporté par le quotidien sud-coréen Seoul Economic Daily, qui cite NVIDIA, Microsoft et Google parmi les principaux partenaires de ces contrats, donne une idée de l’ampleur avec laquelle la […]
HBF promet des téraoctets pour l’IA, sans remplacer la HBM
High Bandwidth Flash (HBF) vise un espace encore peu occupé dans les accélérateurs IA : une capacité bien supérieure à celle de la HBM, avec un débit très au-dessus de la NAND classique. Une analyse présentée par OXMIQ Labs lors de Hot Chips 2026 montre toutefois que cette combinaison a ses limites. La HBF peut […]
NVIDIA investit 3,5 milliards dans MediaTek pour étendre son alliance IA
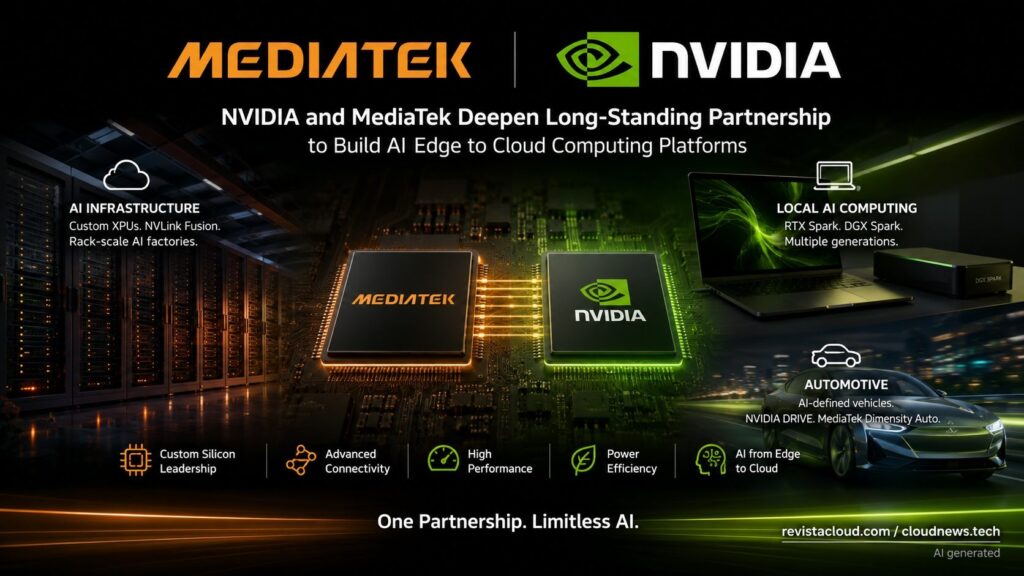
NVIDIA et MediaTek renforcent leur partenariat pour développer conjointement de nouvelles plateformes d’intelligence artificielle couvrant les centres de données, les ordinateurs personnels et l’automobile. L’accord comporte aussi un volet financier conséquent : NVIDIA a investi 3,5 milliards de dollars en obligations convertibles émises par MediaTek, pendant que le fabricant taïwanais intègre NVLink Fusion à son […]
D-Matrix empile la DRAM sur la puce et vise 100 To/s en inférence IA
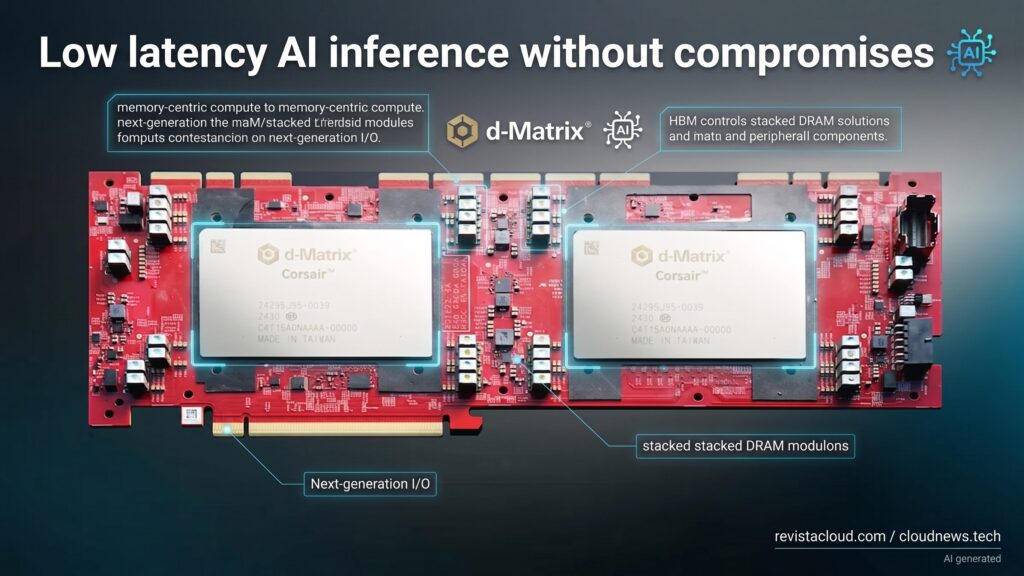
d-Matrix a présenté lors de Hot Chips 2026 de nouveaux détails sur Raptor, sa prochaine génération d’accélérateurs pour l’inférence en intelligence artificielle, bâtie sur une architecture peu conventionnelle : intégrer la puce de calcul directement sur une DRAM conçue sur mesure. Le résultat promis atteint jusqu’à 100 To/s de bande passante par carte avec 32 […]
Auto Router d’OpenRouter change les règles : un modèle différent pour chaque tâche
Choisir un seul modèle d’IA pour toute une application a de moins en moins de sens à mesure que le catalogue de LLM disponibles s’élargit. Auto Router d’OpenRouter renverse la logique : l’application envoie la requête, et le système décide lui-même quel modèle est le plus adapté, selon le type de tâche, le niveau de […]
CXMT accélère avec LPDDR6 et Xiaomi l’adoptera dans son prochain smartphone pliable
Le fabricant chinois de mémoire ChangXin Memory Technologies (CXMT) a annoncé le démarrage de la production en série de sa mémoire LPDDR6, dont l’un des premiers usages commerciaux confirmés équipera le Xiaomi 18 Fold prévu pour septembre. Cette étape place CXMT parmi les rares acteurs capables de faire passer la nouvelle génération de DRAM mobile […]
NVIDIA envisage de réduire le HBM de Rubin Ultra : l’IA commence à privilégier la vitesse
NVIDIA envisage de réduire la quantité de mémoire HBM prévue pour Rubin Ultra, sa prochaine génération d’accélérateurs d’intelligence artificielle, en réponse à la pénurie de DRAM et au coût de la mémoire, ainsi qu’aux difficultés de fabrication des configurations les plus complexes. TrendForce confirme que la société étudie des alternatives à 8 ou 12 couches, […]
Ollama dépasse presque la vitesse des LLM sur Mac avec MLX, mais à une condition
Ollama a opéré une modification majeure de son architecture pour exécuter des modèles d’intelligence artificielle sur les Mac équipés de la puce Apple Silicon. Depuis la version 0.19, il intègre en phase pilote un moteur basé sur MLX, le framework d’apprentissage automatique développé par Apple, capable de faire passer la vitesse de génération du modèle […]
MSI XpertStation WS300 : le superchip NVIDIA GB300 débarque sur un bureau
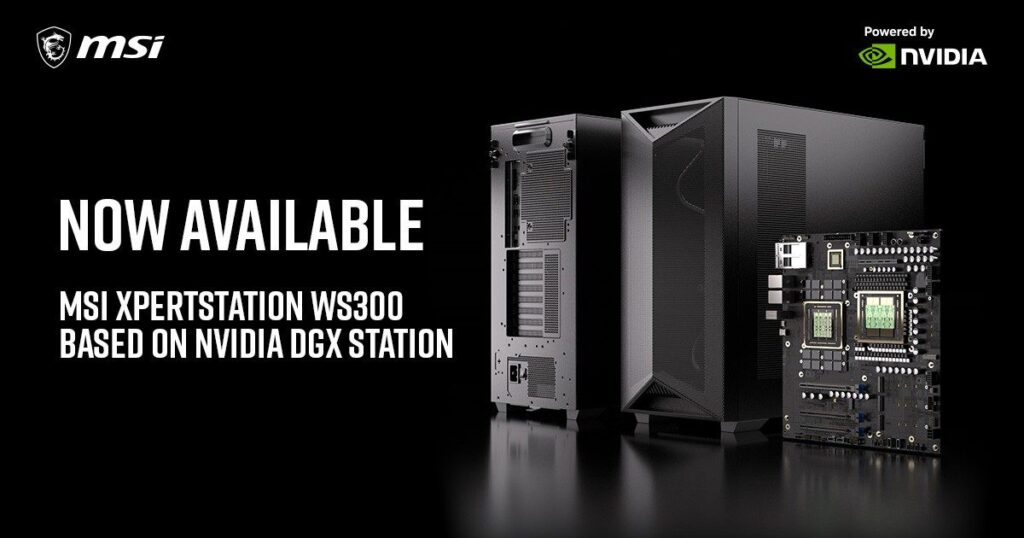
MSI commercialise la XpertStation WS300, une station de travail bâtie sur l’architecture NVIDIA DGX Station et animée par le superchip NVIDIA GB300 Grace Blackwell Ultra. Avec jusqu’à 748 Go de mémoire cohérente, la machine vise à faire tourner localement de grands modèles de langage, du fine-tuning et des agents IA, sans passer systématiquement par une […]
Semicon 2.0 : l’Inde vise les puces de 3 nm d’ici huit ans
L’Inde ne veut plus se contenter de son statut de puissance dans la fabrication électronique et la conception de puces. Le gouvernement prépare Semicon 2.0, une nouvelle étape de sa stratégie nationale qui élargit les investissements à pratiquement toute la chaîne de valeur des semi-conducteurs : fabrication, conception, matériaux, machines, encapsulage avancé, recherche et formation […]