Les TPU de Google se sont fait une place dans l’inférence de modèles de langage grâce à leur coût par token plus qu’à leur vitesse de réponse, et la septième génération, Ironwood (TPU7x), multiplie par 4,5 la bande passante mémoire de sa devancière, Trillium (TPU v6e). C’est sur ce chiffre que Sonnet Xu (@sonnet_xu) construit une analyse publiée sur X le 04/11/2026, dans laquelle il avance que ce saut pourrait permettre à Google de concurrencer aussi sur la latence, un terrain où NVIDIA a dominé les charges interactives.
Les points clés des TPU de Google en inférence en 30 secondes
- Selon l’analyse de Sonnet Xu sur X, l’avantage historique des TPU a été le débit avec des requêtes regroupées par lots, pas la latence.
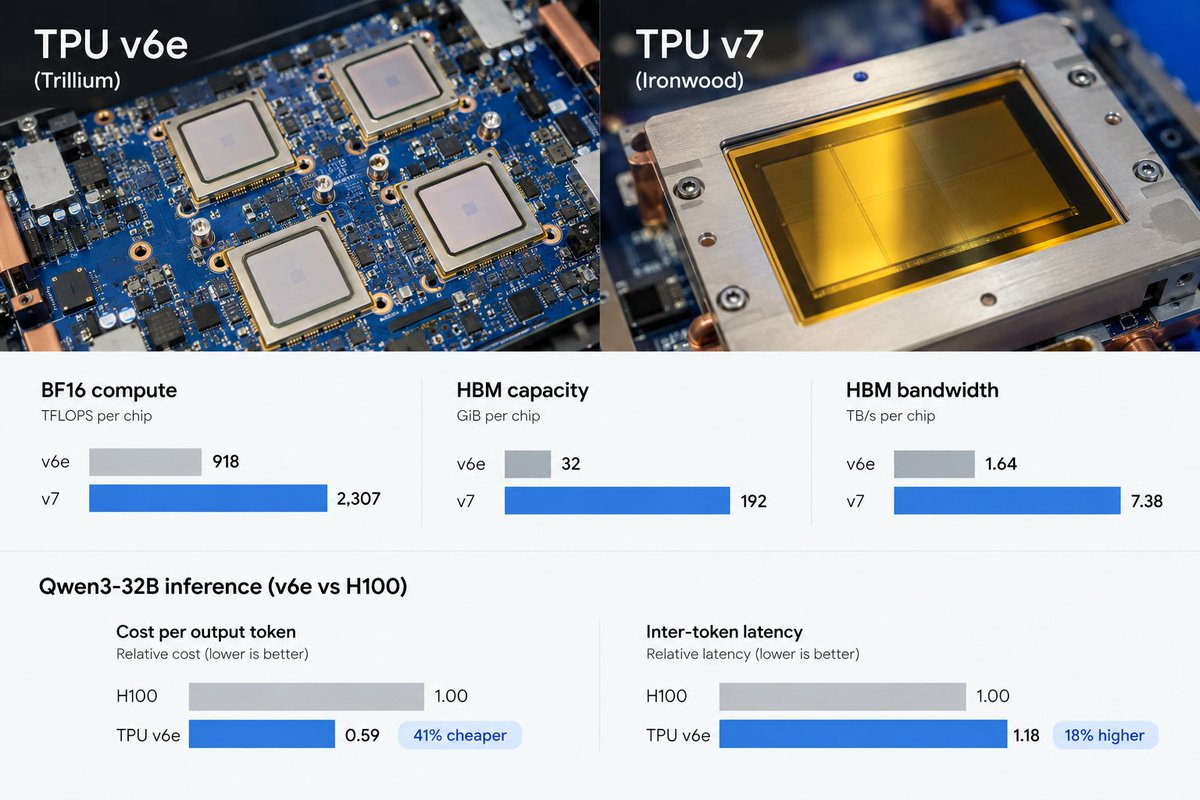
- Dans un benchmark avec Qwen3-32B dont il ne détaille pas l’origine, le TPU v6e est ressorti 41 % moins cher par token de sortie que le H100 de NVIDIA, avec 18 % de latence en plus entre les tokens.
- La documentation de Google confirme 7,38 To/s de bande passante mémoire par puce sur le TPU7x, contre 1,64 To/s sur le v6e.
- Google renforce parallèlement le logiciel d’inférence pour TPU avec vLLM et SGLang.
Un TPU (unité de traitement tensoriel) est l’accélérateur que Google conçoit pour ses propres modèles et qu’elle loue sur Google Cloud. Contrairement à un GPU, d’usage plus général, son cœur de calcul est organisé en grandes matrices systoliques, des blocs de multiplicateurs que les données traversent de façon rythmée et qui donnent leur plein rendement avec des multiplications de matrices denses. Xu soutient que cette architecture favorise le traitement par lots et l’inférence asynchrone, où ce qui compte, c’est le nombre de tokens générés par euro plus que le temps que met chacun à arriver.
41 % moins cher, mais 18 % plus lent entre les tokens
Le chiffre central de l’analyse provient d’une comparaison avec Qwen3-32B, un modèle ouvert d’Alibaba de 32 milliards de paramètres. Le TPU v6e y a obtenu un coût relatif par token de sortie de 0,59 contre 1,00 pour le H100, soit 41 % de moins. La latence entre tokens, le temps qui s’écoule entre un mot généré et le suivant, était de 1,18 contre 1,00 : 18 % de moins bien. La publication de Xu ne renvoie pas à l’étude d’origine et Revista Cloud n’a pas pu la retrouver sur le blog de Google Cloud, sur celui de vLLM ni dans la documentation de SGLang ; ce chiffre doit donc être lu comme faisant partie de son analyse et non comme un résultat vérifié de façon indépendante.
Ce schéma correspond à d’autres données publiées, avec des nuances. Un travail publié sur arXiv en juin 2026 sur Gemma 4 31B, servi avec vLLM sur un TPU v6e-8 face à deux H100 de 80 Go, a lui aussi calculé un coût par token de sortie inférieur de 41 % sur le TPU, mais seulement avec des contextes longs, de 4 096 tokens ou plus. Avec des contextes courts, jusqu’à 2 048 tokens, le GPU s’est révélé 3 % moins cher, et avec des entrées de 128 tokens, la latence entre tokens au 99e percentile a été un peu plus élevée sur le TPU (22,29 contre 20,49 millisecondes). C’est un autre modèle et une autre configuration, mais cela montre que la comparaison dépend beaucoup du type de charge.
L’explication technique tient à la mémoire. Dans la phase de décodage, quand le modèle génère du texte token après token, chaque étape oblige à lire les poids et le cache d’attention depuis la HBM (mémoire à haute bande passante). Avec de petits lots, qui sont la norme dans un chat ou dans un agent qui répond en temps réel, le calcul attend la mémoire. C’est pourquoi la bande passante pèse davantage sur la latence que la puissance brute.
Ce que disent les spécifications officielles d’Ironwood et de Trillium
Les chiffres de l’image qui accompagne la publication coïncident pour l’essentiel avec la documentation de Google Cloud, avec quelques arrondis et une différence d’unités. Le tableau reprend les valeurs par puce des pages officielles du TPU v6e et du TPU7x.
| Spécification par puce | TPU v6e (Trillium) | TPU7x (Ironwood) |
|---|---|---|
| Calcul maximal BF16 | 918 TFLOPS | 2 307 TFLOPS |
| Calcul maximal 8 bits | 1 836 TOPS (INT8) | 4 614 TFLOPS (FP8) |
| Capacité HBM | 32 Go (environ 31,25 Gio utilisables) | 192 Gio |
| Bande passante HBM | 1 638 Go/s | 7 380 Go/s |
| Interconnexion entre puces (ICI, bidirectionnelle) | 800 Go/s | 1 200 Go/s |
| Puces par pod | 256 | 9 216 |
Les TFLOPS mesurent des billions d’opérations en virgule flottante par seconde. Le BF16 (bfloat16) est un format de 16 bits très utilisé en IA, et le FP8 un format de 8 bits qui permet de doubler les performances théoriques. Lorsque Google a présenté Ironwood en avril 2025, elle annonçait 4 614 TFLOPS par puce, un chiffre qui correspond au FP8 ; la valeur BF16 de 2 307 TFLOPS qui figure dans la documentation et sur l’image en représente exactement la moitié.
Le « 4,5 fois » est lui aussi cohérent : 7 380 divisé par 1 638 donne 4,5, et Google a utilisé ce même multiple face à Trillium lors de sa présentation, où elle évoquait 7,37 To/s. La capacité mémoire est multipliée par six. Le seul écart tient aux unités : l’image exprime la mémoire du v6e en Gio, alors que la page officielle parle de 32 Go et précise que les outils rapportent environ 31,25 Gio utilisables. Sur Ironwood, c’est l’inverse : l’annonce de 2025 disait 192 Go et la documentation actuelle utilise 192 Gio.
Le saut se voit aussi dans le prix. Le tarif public de Google Cloud consulté pour cet article fixe Trillium à 2,70 dollars par puce et par heure à la demande en us-east5 (Ohio) et Ironwood à 12,00 dollars en us-central1 (Iowa), avec des remises d’engagement à un et trois ans. En novembre 2025, en annonçant la disponibilité générale, Google a affirmé qu’Ironwood offre plus de quatre fois les performances par puce de Trillium en entraînement comme en inférence. Le coût par token dépendra de la part de cette amélioration qui se répercutera sur chaque modèle concret.
vLLM, SGLang et clients : le logiciel décide de la latence
Le matériel n’est qu’une partie du tableau. En octobre 2025, une équipe de Google a présenté sur le blog de vLLM le nouveau backend tpu-inference, qui unifie JAX et PyTorch sous un même chemin de compilation vers XLA. Selon cette annonce, les performances ont été multipliées par 3,6 avec Llama 3.1-8B sur un v6e-1 et par 2,1 avec Llama 3.1-70B sur un v6e-8 par rapport à son travail antérieur de 2025. SGLang, l’autre grand moteur de service ouvert, maintient deux backends pour TPU : SGL-JAX, compatible avec les v6e et v7, et SGLang-TorchTPU, centré sur le TPU7x. À cela s’ajoute le pari de Google d’exécuter PyTorch de façon native sur ses TPU avec TorchTPU.
La demande externe a elle aussi progressé. Google et Anthropic ont annoncé en octobre 2025 que l’entreprise de Claude prévoit d’accéder à jusqu’à un million de TPU de Google Cloud, et lors de l’annonce de la disponibilité générale d’Ironwood, son responsable du calcul, James Bradbury, a souligné les améliorations de la puce tant en performances d’inférence qu’en capacité de passage à l’échelle de l’entraînement. Revista Cloud a déjà analysé comment les TPU de Google défient NVIDIA en performances par dollar.
Xu conclut que la prochaine vague de demande d’inférence sera interactive et fondée sur des agents, et que si les TPU parviennent à rivaliser sur la latence, en plus du coût, ils pourraient passer du traitement par lots bon marché aux charges les plus coûteuses, historiquement aux mains de NVIDIA. C’est une hypothèse raisonnable au vu de la bande passante d’Ironwood, mais il n’existe pour l’instant aucune comparaison publique et vérifiable de la latence entre tokens d’Ironwood face aux GPU actuels de NVIDIA avec le même modèle et le même moteur.
Questions fréquentes
Quelle bande passante mémoire a Ironwood par rapport à Trillium ?
Selon la documentation de Google Cloud, le TPU7x (Ironwood) atteint 7 380 Go/s par puce et le TPU v6e (Trillium) 1 638 Go/s, soit environ 4,5 fois moins. La capacité HBM passe de 32 Go à 192 Gio.
Le TPU v6e est-il moins cher que le H100 pour l’inférence ?
Dans le benchmark avec Qwen3-32B que cite Sonnet Xu, le v6e est ressorti 41 % moins cher par token de sortie, mais avec 18 % de latence en plus entre les tokens. L’origine de ce test n’est pas identifiée, et une autre étude avec Gemma 4 31B n’a trouvé cet avantage qu’avec des contextes longs.
Ironwood égale-t-il déjà NVIDIA sur la latence ?
Aucune donnée publique vérifiable ne le démontre. La bande passante mémoire accrue devrait aider au décodage, mais il manque une comparaison avec le même modèle, le même moteur et la même configuration.
Combien coûte la location d’un TPU Ironwood sur Google Cloud ?
Le tarif public affiche 12,00 dollars par puce et par heure à la demande en us-central1, contre 2,70 dollars pour Trillium en us-east5. Des remises d’engagement à un et trois ans existent.
Sources :
- Sonnet Xu (@sonnet_xu) sur X, 04/11/2026
- Google Cloud : TPU7x (Ironwood)
- Google Cloud : TPU v6e
- Google : Ironwood, the first Google TPU for the age of inference (09/04/2025)
- Google Cloud Blog : Ironwood TPUs and new Axion-based VMs (06/11/2025)
- Google Cloud : Cloud TPU pricing
- vLLM : vLLM TPU, a new unified backend supporting PyTorch and JAX on TPU (16/10/2025)
- SGLang : documentation pour TPU
- arXiv : Fine-Tuning and Serving Gemma 4 31B on Google Cloud TPU (juin 2026)