Catégorie : Cloud

La Chine menace d’éclater la bulle des prix de la mémoire DDR5

Samsung verrouille 70 % de sa mémoire jusqu’en 2031 sous la pression de l’IA

Samsung Electronics aurait engagé environ 70 % de sa capacité de production de mémoire dans des accords d’approvisionnement à long terme courant jusqu’en 2031. Le chiffre, rapporté par le quotidien sud-coréen Seoul Economic Daily, qui cite NVIDIA, Microsoft et Google parmi les principaux partenaires de ces contrats, donne une idée de l’ampleur avec laquelle la demande d’infrastructure IA redéfinit le marché de la DRAM et du HBM. L’essentiel en 20 secondes Samsung aurait réservé environ 70 % de sa capacité mémoire via des contrats à long terme jusqu’en 2031. NVIDIA, Microsoft et Google figurent parmi les clients cités. Le HBM3E acheté sur le marché spot coûte quatre à cinq fois plus cher que via certains contrats. La transition vers le
HBF promet des téraoctets pour l'IA, mais ne sera pas un substitut direct de la HBM

HBF promet des téraoctets pour l’IA, sans remplacer la HBM

High Bandwidth Flash (HBF) vise un espace encore peu occupé dans les accélérateurs IA : une capacité bien supérieure à celle de la HBM, avec un débit très au-dessus de la NAND classique. Une analyse présentée par OXMIQ Labs lors de Hot Chips 2026 montre toutefois que cette combinaison a ses limites. La HBF peut faire une vraie différence quand il s’agit de loger un modèle volumineux près du processeur, mais elle perd une bonne partie de son intérêt dès que la charge doit déplacer ces données en continu et à grande vitesse. L’essentiel en 20 secondes La HBF empile de la NAND 3D pour rapprocher plusieurs centaines de gigaoctets des accélérateurs IA. La spécification prévoit jusqu’à 512 Go par

Stackscale vs Naranjatec : pourquoi le prix par vCPU ne raconte pas toute l'histoire

Stackscale vs Naranjatec : le prix par vCPU ne dit pas tout

Une étude comparative publiée par Naranjatec présente son Cloud Privé comme une alternative plus économique à Stackscale, en se basant sur le coût du CPU, de la RAM et du stockage. Ce genre de tableau donne une idée approximative du prix de certaines ressources, mais ne suffit pas à déterminer quelle plateforme coûte vraiment moins cher quand les architectures, le modèle de calcul, le stockage, la haute disponibilité et les services associés ne sont pas équivalents. Et dans un marché où le coût du matériel, la mémoire en tête, fluctue en permanence, transformer des prix ponctuels en conclusions définitives rend vite toute comparaison obsolète. La comparaison Stackscale-Naranjatec en 30 secondes Naranjatec compare des ressources virtuelles à une infrastructure Stackscale basée

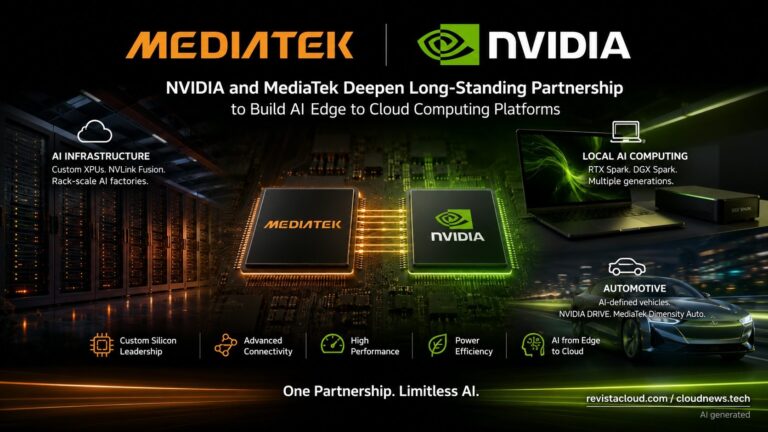
NVIDIA investit 3,5 milliards dans MediaTek et élargit son partenariat pour l'IA

NVIDIA investit 3,5 milliards dans MediaTek pour étendre son alliance IA

NVIDIA et MediaTek renforcent leur partenariat pour développer conjointement de nouvelles plateformes d’intelligence artificielle couvrant les centres de données, les ordinateurs personnels et l’automobile. L’accord comporte aussi un volet financier conséquent : NVIDIA a investi 3,5 milliards de dollars en obligations convertibles émises par MediaTek, pendant que le fabricant taïwanais intègre NVLink Fusion à son offre de silicium personnalisé pour l’infrastructure IA. Le partenariat NVIDIA-MediaTek en 30 secondes NVIDIA investit 3,5 milliards de dollars en obligations convertibles de MediaTek. MediaTek adopte NVLink Fusion pour développer des XPU personnalisés intégrables dans des systèmes NVIDIA à l’échelle du rack. La collaboration se poursuit sur plusieurs générations de puces RTX Spark et DGX Spark. Les deux entreprises élargissent leur coopération sur les plateformes

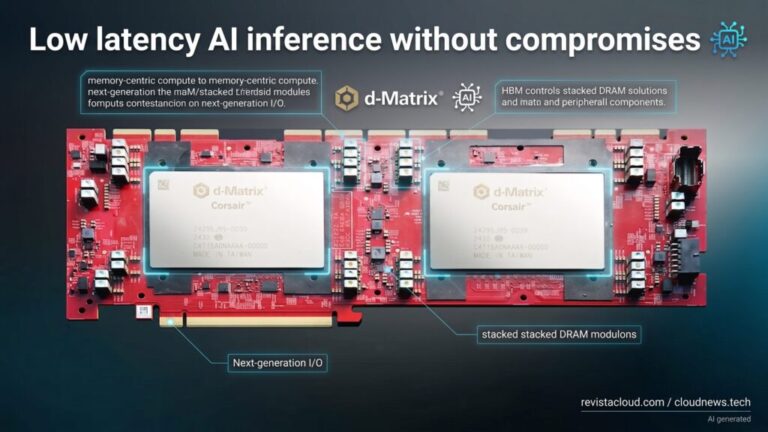
D-Matrix place la DRAM au-dessus de la puce pour atteindre 100 To/s en inférence IA

D-Matrix empile la DRAM sur la puce et vise 100 To/s en inférence IA

d-Matrix a présenté lors de Hot Chips 2026 de nouveaux détails sur Raptor, sa prochaine génération d’accélérateurs pour l’inférence en intelligence artificielle, bâtie sur une architecture peu conventionnelle : intégrer la puce de calcul directement sur une DRAM conçue sur mesure. Le résultat promis atteint jusqu’à 100 To/s de bande passante par carte avec 32 Go de mémoire, une valeur qui vise à repousser l’un des principaux obstacles de l’inférence générative : déplacer les données vers les unités de calcul assez vite, sans faire exploser la consommation. Raptor et sa mémoire 3D en 30 secondes Raptor superpose un die de calcul en 4 nm sur une DRAM via une liaison face-à-face avec des connexions de 36 micromètres. L’architecture atteint jusqu’à

Le Mac mini M5 se fait attendre : l'IA locale et la crise de mémoire changent le paysage

OpenAI achète des dizaines de milliers de Mac alors que la demande en IA locale augmente

Les Mac mini et Mac Studio sont devenus des éléments inattendus de l’infrastructure utilisée par certains des plus grands laboratoires d’intelligence artificielle. Selon des sources, OpenAI aurait acheté des dizaines de milliers d’ordinateurs Apple pour des travaux liés à l’apprentissage par renforcement et aux agents capables d’utiliser ces ordinateurs, tandis qu’Anthropic louerait des Mac mini via Amazon Web Services (AWS). Parallèlement, la demande s’étend également aux équipements compacts basés sur NVIDIA, ce qui indique un marché en croissance pour exécuter de l’IA en dehors des grands clusters GPU traditionnels. Les clés des Mac en infrastructure d’IA en 30 secondes OpenAI aurait acquis des dizaines de milliers de Mac mini et Mac Studio pour l’apprentissage par renforcement et le développement d’agents.

La Chine menace d’éclater la bulle des prix de la mémoire DDR5

Samsung verrouille 70 % de sa mémoire jusqu’en 2031 sous la pression de l’IA

Samsung Electronics aurait engagé environ 70 % de sa capacité de production de mémoire dans des accords d’approvisionnement à long terme courant jusqu’en 2031. Le chiffre, rapporté par le quotidien sud-coréen Seoul Economic Daily, qui cite NVIDIA, Microsoft et Google parmi les principaux partenaires de ces contrats, donne une idée de l’ampleur avec laquelle la demande d’infrastructure IA redéfinit le marché de la DRAM et du HBM. L’essentiel en 20 secondes Samsung aurait réservé environ 70 % de sa capacité mémoire via des contrats à long terme jusqu’en 2031. NVIDIA, Microsoft et Google figurent parmi les clients cités. Le HBM3E acheté sur le marché spot coûte quatre à cinq fois plus cher que via certains contrats. La transition vers le
HBF promet des téraoctets pour l'IA, mais ne sera pas un substitut direct de la HBM

HBF promet des téraoctets pour l’IA, sans remplacer la HBM

High Bandwidth Flash (HBF) vise un espace encore peu occupé dans les accélérateurs IA : une capacité bien supérieure à celle de la HBM, avec un débit très au-dessus de la NAND classique. Une analyse présentée par OXMIQ Labs lors de Hot Chips 2026 montre toutefois que cette combinaison a ses limites. La HBF peut faire une vraie différence quand il s’agit de loger un modèle volumineux près du processeur, mais elle perd une bonne partie de son intérêt dès que la charge doit déplacer ces données en continu et à grande vitesse. L’essentiel en 20 secondes La HBF empile de la NAND 3D pour rapprocher plusieurs centaines de gigaoctets des accélérateurs IA. La spécification prévoit jusqu’à 512 Go par

Stackscale vs Naranjatec : pourquoi le prix par vCPU ne raconte pas toute l'histoire

Stackscale vs Naranjatec : le prix par vCPU ne dit pas tout

Une étude comparative publiée par Naranjatec présente son Cloud Privé comme une alternative plus économique à Stackscale, en se basant sur le coût du CPU, de la RAM et du stockage. Ce genre de tableau donne une idée approximative du prix de certaines ressources, mais ne suffit pas à déterminer quelle plateforme coûte vraiment moins cher quand les architectures, le modèle de calcul, le stockage, la haute disponibilité et les services associés ne sont pas équivalents. Et dans un marché où le coût du matériel, la mémoire en tête, fluctue en permanence, transformer des prix ponctuels en conclusions définitives rend vite toute comparaison obsolète. La comparaison Stackscale-Naranjatec en 30 secondes Naranjatec compare des ressources virtuelles à une infrastructure Stackscale basée

NVIDIA investit 3,5 milliards dans MediaTek et élargit son partenariat pour l'IA

NVIDIA investit 3,5 milliards dans MediaTek pour étendre son alliance IA

NVIDIA et MediaTek renforcent leur partenariat pour développer conjointement de nouvelles plateformes d’intelligence artificielle couvrant les centres de données, les ordinateurs personnels et l’automobile. L’accord comporte aussi un volet financier conséquent : NVIDIA a investi 3,5 milliards de dollars en obligations convertibles émises par MediaTek, pendant que le fabricant taïwanais intègre NVLink Fusion à son offre de silicium personnalisé pour l’infrastructure IA. Le partenariat NVIDIA-MediaTek en 30 secondes NVIDIA investit 3,5 milliards de dollars en obligations convertibles de MediaTek. MediaTek adopte NVLink Fusion pour développer des XPU personnalisés intégrables dans des systèmes NVIDIA à l’échelle du rack. La collaboration se poursuit sur plusieurs générations de puces RTX Spark et DGX Spark. Les deux entreprises élargissent leur coopération sur les plateformes

D-Matrix place la DRAM au-dessus de la puce pour atteindre 100 To/s en inférence IA

D-Matrix empile la DRAM sur la puce et vise 100 To/s en inférence IA

d-Matrix a présenté lors de Hot Chips 2026 de nouveaux détails sur Raptor, sa prochaine génération d’accélérateurs pour l’inférence en intelligence artificielle, bâtie sur une architecture peu conventionnelle : intégrer la puce de calcul directement sur une DRAM conçue sur mesure. Le résultat promis atteint jusqu’à 100 To/s de bande passante par carte avec 32 Go de mémoire, une valeur qui vise à repousser l’un des principaux obstacles de l’inférence générative : déplacer les données vers les unités de calcul assez vite, sans faire exploser la consommation. Raptor et sa mémoire 3D en 30 secondes Raptor superpose un die de calcul en 4 nm sur une DRAM via une liaison face-à-face avec des connexions de 36 micromètres. L’architecture atteint jusqu’à

Le Mac mini M5 se fait attendre : l'IA locale et la crise de mémoire changent le paysage

OpenAI achète des dizaines de milliers de Mac alors que la demande en IA locale augmente

Les Mac mini et Mac Studio sont devenus des éléments inattendus de l’infrastructure utilisée par certains des plus grands laboratoires d’intelligence artificielle. Selon des sources, OpenAI aurait acheté des dizaines de milliers d’ordinateurs Apple pour des travaux liés à l’apprentissage par renforcement et aux agents capables d’utiliser ces ordinateurs, tandis qu’Anthropic louerait des Mac mini via Amazon Web Services (AWS). Parallèlement, la demande s’étend également aux équipements compacts basés sur NVIDIA, ce qui indique un marché en croissance pour exécuter de l’IA en dehors des grands clusters GPU traditionnels. Les clés des Mac en infrastructure d’IA en 30 secondes OpenAI aurait acquis des dizaines de milliers de Mac mini et Mac Studio pour l’apprentissage par renforcement et le développement d’agents.