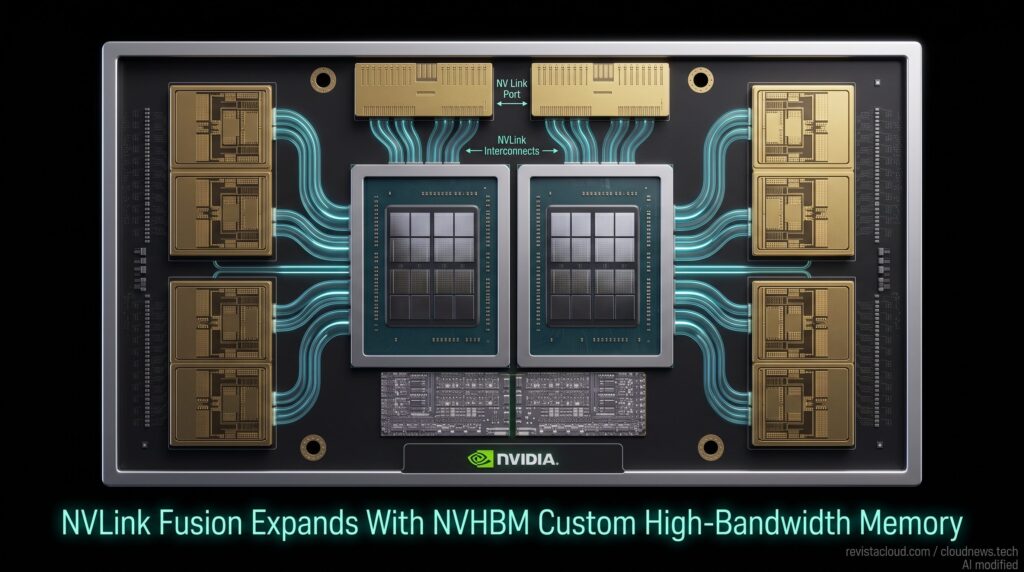
NVIDIA a dévoilé NVHBM, une architecture mémoire à haut débit qui déplace le contrôleur depuis l’accélérateur vers le socle de la pile HBM. Selon l’entreprise, ce déplacement offre jusqu’à 30 % de bande passante supplémentaire, réduit la consommation mémoire de 15 % et libère jusqu’à 25 % de l’espace sur le XPU comparé à une implémentation classique en HBM4E. La technologie s’intègre à NVLink Fusion, et Annapurna Labs, la division puces d’Amazon Web Services, en sera le premier partenaire.
L’annonce arrive alors que la mémoire devient un facteur aussi déterminant que le calcul pour la performance des accélérateurs IA. Des modèles de plusieurs centaines de milliards, voire de plusieurs trillions de paramètres, imposent un déplacement massif de données entre mémoire et unités de calcul : augmenter les FLOPS disponibles ne sert à rien si le processeur passe son temps à attendre que les données arrivent. NVHBM s’attaque directement à cette relation entre calcul et mémoire.
Le contrôleur quitte le XPU pour rejoindre la pile HBM
Dans une architecture HBM classique, le contrôleur chargé de la communication mémoire se trouve dans l’accélérateur lui-même, ce qui réserve une partie du silicium du XPU à cette tâche plutôt qu’au calcul. NVIDIA propose l’inverse avec NVHBM : le contrôleur personnalisé rejoint le socle de la pile HBM tridimensionnelle, hors du die principal du XPU.
| Couche d’infrastructure | Technologies NVIDIA |
|---|---|
| Calcul | GPU, Grace et plateformes à l’échelle rack |
| Mémoire | NVHBM et contrôleurs |
| Scale-up | NVLink et NVLink Switch |
| Communication chip à chip | NVLink-C2C |
| Réseau | Spectrum-X et InfiniBand |
| Systèmes | MGX et racks NVIDIA |
| Logiciels | CUDA et bibliothèques IA |
| Puces personnalisées | NVLink Fusion |
NVIDIA n’a donc plus besoin de fabriquer tous les composants d’un système pour que sa technologie en fasse partie intégrante. Un hyperscaler peut concevoir sa propre XPU en s’appuyant sur NVLink pour la connectivité et NVHBM pour la mémoire, tout en intégrant les autres briques NVIDIA à l’échelle du rack, sans devoir tout redévelopper à chaque nouvelle charge de travail.
Reste à vérifier combien de ces 30 % de bande passante et 15 % d’économie d’énergie se maintiendront une fois NVHBM commercialisé, et quels fabricants de mémoire rejoindront cette norme. Mais la direction est claire : la compétition ne consiste plus seulement à fabriquer le GPU le plus rapide, elle porte désormais sur qui contrôle la communication entre calcul, mémoire et centaines d’accélérateurs au sein d’un même système.
Questions fréquentes
Qu’est-ce que NVIDIA NVHBM ?
Une technologie de mémoire à haut débit qui intègre le contrôleur personnalisé de NVIDIA directement dans le socle de la pile HBM, plutôt que dans le XPU lui-même.
Quels avantages NVHBM offre-t-il face à HBM4E ?
Jusqu’à 30 % de bande passante supplémentaire, une réduction de 15 % de la consommation mémoire, et jusqu’à 25 % de surface libérée sur le XPU comparé à une architecture HBM4E classique.
NVHBM sera-t-il réservé aux GPU NVIDIA ?
Non. L’intégration dans des processeurs tiers via NVLink Fusion est au cœur de l’annonce, et NVIDIA prévoit une norme commune proposée par plusieurs fournisseurs de mémoire.
Quel est le lien avec AWS ?
Annapurna Labs, la division puces d’Amazon, sera le premier partenaire de NVHBM, dans le cadre d’une stratégie plus large autour de NVLink Fusion et des futures générations Trainium d’AWS.
source : blogs.nvidia
| Caractéristique | HBM4E conventionnel | NVHBM de NVIDIA |
|---|---|---|
| Contrôleur mémoire | Dans le XPU | Dans le socle de HBM |
| Bande passante | Référence | Jusqu’à +30 % |
| Consommation HBM | Référence | -15 % |
| Surface disponible en plus sur le XPU | — | Jusqu’à +25 % |
Les chiffres publiés par NVIDIA restent des estimations préliminaires, à confirmer sur des produits concrets une fois NVHBM commercialisé. Et cela ne garantit pas 25 % de performance en plus pour tout accélérateur : NVIDIA parle d’optimisation de la surface silicium, pas de rendement supplémentaire direct en calcul. L’intérêt pour les concepteurs tient surtout à la liberté d’usage de cet espace libéré, qu’ils peuvent consacrer à plus d’unités de calcul, à des caches plus grands, à des accélérateurs spécialisés ou à un XPU globalement plus efficace.
NVIDIA veut aussi s’inviter dans les puces personnalisées de ses clients
NVHBM prend tout son sens comme brique de NVLink Fusion, la stratégie par laquelle NVIDIA veut que les puces personnalisées de ses concurrents utilisent aussi NVLink. Les grands fournisseurs cloud développent depuis plusieurs années leurs propres accélérateurs pour réduire leurs coûts et coller aux besoins de leurs charges de travail : Google avec ses TPU, AWS avec Trainium et Inferentia, Microsoft avec Maia, Meta avec MTIA. Chaque puce sur mesure déployée par un hyperscaler pourrait réduire d’autant la dépendance aux GPU NVIDIA.
NVLink Fusion propose une autre lecture de ce mouvement. Plutôt que d’obliger ses clients à choisir entre un accélérateur NVIDIA ou un ASIC maison, NVIDIA veut que ces processeurs spécifiques utilisent aussi ses composants : NVLink, NVLink-C2C, NVLink Switch, MGX, et désormais NVHBM. L’entreprise décrit cette stratégie comme une architecture « verticalement intégrée et horizontalement ouverte », une façon de participer économiquement à l’écosystème IA même quand le processeur principal porte la marque d’un concurrent.
AWS, premier partenaire de NVHBM
Annapurna Labs, la division d’Amazon responsable d’une bonne partie des circuits personnalisés d’AWS, collaborera avec NVIDIA sur NVHBM et sur la plateforme NVLink pour le déploiement en rack. Ce partenariat élargit l’accord existant autour de NVLink Fusion : AWS prévoit d’intégrer la technologie dès Trainium4, la prochaine génération de ses accélérateurs maison, qui a déjà pris le relais de Trainium3 présenté lors d’AWS re:Invent et qui génère déjà plus de 25 milliards de dollars par an pour Amazon.
L’objectif : faire cohabiter puces Amazon et GPU NVIDIA dans une architecture commune à l’échelle du rack. Même en construisant ses propres accélérateurs, AWS peut ainsi exploiter la technologie d’interconnexion et de gestion mémoire de NVIDIA pour assembler des systèmes hétérogènes, adaptés charge par charge.
La course à l’IA se joue aussi sur la mémoire
Au début de l’essor de l’IA, la performance se mesurait surtout en TFLOPS ou en PFLOPS. À mesure que les modèles grossissent, la capacité et la largeur de la mémoire pèsent tout autant. Le HBM empile plusieurs couches de DRAM reliées par des interfaces ultrarapides, et les générations se sont succédé depuis HBM2 jusqu’à HBM4 et au-delà. Déplacer le contrôleur vers le socle de la pile va plus loin : la mémoire cesse d’être un simple composant connecté au processeur pour assumer des fonctions autrefois réservées au CPU.
NVIDIA veut aussi généraliser une implémentation standardisée de NVHBM, proposée par plusieurs fabricants de mémoire, ce qui allégerait le travail d’intégration et de validation pour les concepteurs d’ASIC et permettrait à NVIDIA d’étendre son emprise sur cette couche stratégique sans devenir fabricant de DRAM.
De CUDA et des GPU à toute l’infrastructure du rack
NVHBM s’inscrit dans une logique plus large, celle d’une société dont le Data Center représente désormais environ 92,5 % des revenus trimestriels. Son offre ne se limite plus à vendre des accélérateurs : GPU, CPU, réseaux, NVLink, systèmes rack-scale, logiciels et architectures complètes pour l’IA en data center. NVLink Fusion étend cette stratégie jusqu’à la conception de processeurs personnalisés.
| Couche d’infrastructure | Technologies NVIDIA |
|---|---|
| Calcul | GPU, Grace et plateformes à l’échelle rack |
| Mémoire | NVHBM et contrôleurs |
| Scale-up | NVLink et NVLink Switch |
| Communication chip à chip | NVLink-C2C |
| Réseau | Spectrum-X et InfiniBand |
| Systèmes | MGX et racks NVIDIA |
| Logiciels | CUDA et bibliothèques IA |
| Puces personnalisées | NVLink Fusion |
NVIDIA n’a donc plus besoin de fabriquer tous les composants d’un système pour que sa technologie en fasse partie intégrante. Un hyperscaler peut concevoir sa propre XPU en s’appuyant sur NVLink pour la connectivité et NVHBM pour la mémoire, tout en intégrant les autres briques NVIDIA à l’échelle du rack, sans devoir tout redévelopper à chaque nouvelle charge de travail.
Reste à vérifier combien de ces 30 % de bande passante et 15 % d’économie d’énergie se maintiendront une fois NVHBM commercialisé, et quels fabricants de mémoire rejoindront cette norme. Mais la direction est claire : la compétition ne consiste plus seulement à fabriquer le GPU le plus rapide, elle porte désormais sur qui contrôle la communication entre calcul, mémoire et centaines d’accélérateurs au sein d’un même système.
Questions fréquentes
Qu’est-ce que NVIDIA NVHBM ?
Une technologie de mémoire à haut débit qui intègre le contrôleur personnalisé de NVIDIA directement dans le socle de la pile HBM, plutôt que dans le XPU lui-même.
Quels avantages NVHBM offre-t-il face à HBM4E ?
Jusqu’à 30 % de bande passante supplémentaire, une réduction de 15 % de la consommation mémoire, et jusqu’à 25 % de surface libérée sur le XPU comparé à une architecture HBM4E classique.
NVHBM sera-t-il réservé aux GPU NVIDIA ?
Non. L’intégration dans des processeurs tiers via NVLink Fusion est au cœur de l’annonce, et NVIDIA prévoit une norme commune proposée par plusieurs fournisseurs de mémoire.
Quel est le lien avec AWS ?
Annapurna Labs, la division puces d’Amazon, sera le premier partenaire de NVHBM, dans le cadre d’une stratégie plus large autour de NVLink Fusion et des futures générations Trainium d’AWS.
source : blogs.nvidia