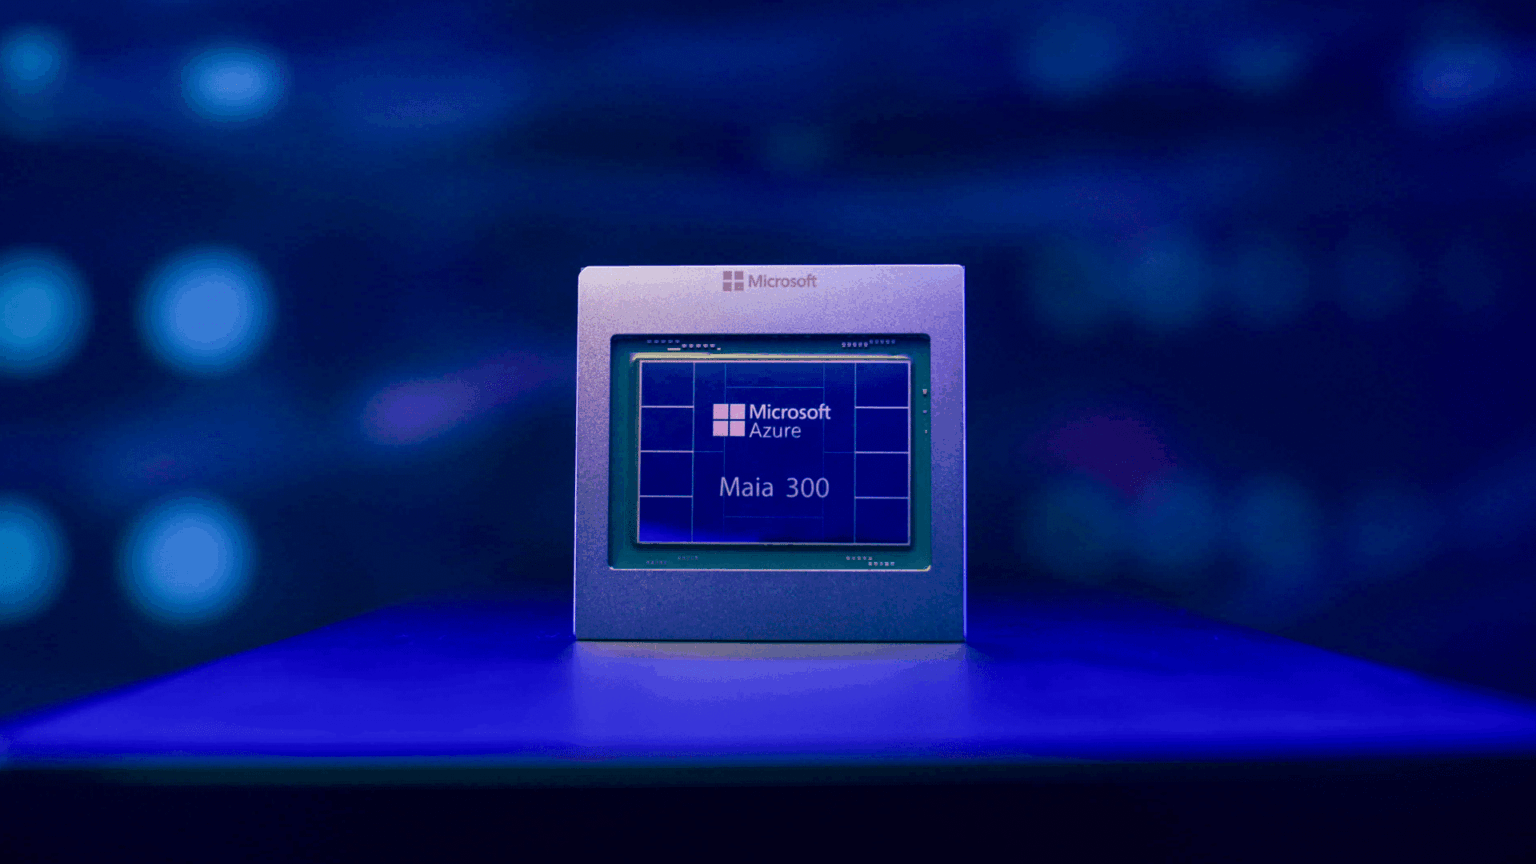
Microsoft élargira sa famille d’accélérateurs d’intelligence artificielle (IA) Azure Maia, visant des déploiements de plusieurs gigawatts à partir de 2027 avec Maia 300 comme nouvelle génération de son infrastructure pour l’exécution des modèles. Le nouveau chipset adopte une architecture multi-chiplet, intègre une mémoire HBM4 à haute bande passante et utilise le procédé N2P de TSMC pour ses chiplets de calcul. La société cherche ainsi à augmenter la capacité d’inférence tout en réduisant la consommation énergétique nécessaire pour ses services IA.
Les points clés de Maia 300 en 20 secondes
- Microsoft prévoit de commencer le déploiement de Maia 300 en production en 2027 et d’étendre son infrastructure Maia à plusieurs gigawatts.
- Chaque accélérateur comporte huit piles de mémoire HBM4, offrant 288 Go de capacité et un débit maximal de 18 To/s.
- Un rack regroupe 96 accélérateurs, pour une capacité totale de 27,6 To de mémoire HBM et une consommation estimée jusqu’à 167 kW.
- Microsoft affirme que Maia 300 peut générer 40 % de tokens en plus par mégawatt par rapport à des systèmes basés sur des GPU de référence.
- Maia 200 est déjà opérationnel dans des environnements de production, notamment pour Microsoft Copilot.
Ce lancement marque une évolution dans l’infrastructure de Microsoft : l’entreprise souhaite s’appuyer de plus en plus sur des accélérateurs conçus pour ses propres charges de travail, plutôt que de dépendre exclusivement de processeurs graphiques généralistes. L’objectif est de répondre aux besoins en modèles de langage, assistants de programmation et systèmes à base d’agents, qui nécessitent d’importantes capacités mémoire et de calcul sur de longues périodes.
Les chiffres de performance fournis par Microsoft sont à considérer comme des déclarations du constructeur. L’entreprise ne communique pas tous les systèmes de référence utilisés ni une méthodologie indépendante permettant de comparer ces résultats dans des conditions identiques.
Maia 300 combine des chiplets TSMC N2P et de la mémoire HBM4
Maia 300 constitue la troisième génération du programme d’accélérateurs propriétaires de Microsoft. Son architecture privilégie la tâche d’inférence, c’est-à-dire l’exécution de modèles déjà entraînés pour générer des réponses, traiter des instructions ou réaliser des tâches spécifiques. Cette activité requiert un équilibre fin entre puissance de calcul et rapidité de traitement des données.
L’un des éléments clés est la mémoire haute bande passante HBM4. Chaque accélérateur intègre huit piles permettant d’atteindre 288 Go de capacité et jusqu’à 18 To/s de bande passante, selon les spécifications de Microsoft. La consommation thermique conçue pour chaque unité est de 950 watts.
La mémoire revêt une importance particulière lorsque les modèles opèrent avec des contextes étendus, maintiennent des conversations longues ou réalisent des tâches à plusieurs étapes. Dans ces scénarios, déplacer des données entre la mémoire et les unités de calcul peut limiter la performance, même si le processeur dispose de ressources suffisantes.
Microsoft mise également sur une architecture de chiplets séparant les fonctions de calcul, les contrôleurs mémoire et les interfaces d’entrée/sortie dans des modules distincts. Cela permet de concevoir chaque composant selon ses besoins spécifiques en termes de performance, connectivité et coût.
Les chiplets de calcul utilisent le procédé N2P de TSMC, technologie avancée de fabrication taïwanaise. Microsoft n’a pas publié tous les détails physiques du silicium ni des données permettant une comparaison exhaustive avec d’autres accélérateurs commerciaux.
Le design incorpore également des formats numériques à faible précision, notamment MXFP4 amélioré, visant à réduire les besoins en mémoire et en bande passante. Il utilise aussi la mémoire SRAM intégrée au sein du chip comme espace de travail, une technique pouvant limiter les accès mémoire externe dans certains cas.
L’architecture s’accompagne d’une structure de communication optimisée, intégrant à la fois des liens électriques intra-rack et des connexions optiques entre racks. Microsoft modélise un système où le transfert de données entre calcul, mémoire et réseau constitue une seule et même chaîne d’exécution, plutôt qu’une couche de communication séparée.
Racks de 167 kW pour une capacité accrue en IA
La configuration de référence de Maia 300 consiste en 96 accélérateurs dans un rack, avec une limite électrique de 167 kilowatts. Au total, cette configuration dispose de 27,6 To de mémoire HBM et atteint un débit global de 1,7 pétaoctets par seconde.
Ces chiffres représentent la capacité collective, et non celle d’un seul chip. La mémoire et la bande passante sont réparties entre les accélérateurs et dépendent de l’architecture d’interconnexion et de la gestion des charges de travail.
La puissance indique aussi les exigences physiques de l’infrastructure. Une telle installation nécessite une conception électrique et thermique adaptée, ainsi qu’un réseau capable d’assurer une communication rapide entre accélérateurs. Microsoft indique que sa conception intègre une refroidissement liquide pour évacuer plus de 80 % de la charge thermique générée par les accélérateurs et leurs régulateurs de tension, circuits de commutation, etc. La mémoire, le stockage et autres composants auxiliaires utilisent un refroidissement par air.
La connectivité combine des liens électriques internes au rack et des connexions optiques inter-racks. La conception réseau vise à évoluer d’un seul rack jusqu’à de vastes regroupements de plusieurs racks, avec intégration dans des superpods pouvant contenir jusqu’à 12 288 accélérateurs répartis sur 128 racks.
La taille de ces déploiements explique pourquoi le coût en énergie par unité de travail est une métrique essentielle pour Microsoft avec Maia 300. La société affirme que chaque rack peut générer jusqu’à sept fois plus de tokens qu’un Maia 200, dans une configuration complète de 96 accélérateurs, avec une augmentation de 40 % en tokens par mégawatt par rapport aux systèmes à base de GPU de référence.
Ces assertions relèvent du fabricant, ne garantissant pas nécessairement le rendement pour telle ou telle application. Les performances réelles dépendront de la architecture, de la longueur du contexte, de la précision numérique utilisée, de l’utilisation mémoire et des conditions d’exécution.
Maia 200 déjà en production et Maia 300 prévue pour 2027
Microsoft différencie déjà son infrastructure actuelle de la prochaine génération. Maia 200 est en production, exécutant des charges internes comme Microsoft Copilot, et supporte également le développement des modèles MAI. La société annonce que GitHub Copilot et Microsoft Foundry intégreront Maia 200 avant la fin 2026.
L’expérience acquise avec Maia 200 oriente le développement de Maia 300. Microsoft cite comme applications principales l’aide à la programmation, l’hébergement de modèles dans le cloud, la génération de données pour entraîner et développer ces modèles, ainsi que des applications cliniques telles que Dragon Copilot.
Selon Microsoft, Maia 200 offre jusqu’à 1,7 fois plus de tokens par watt que l’infrastructure GPU de référence dans certains cas d’usage IA intégrés à Teams, Copilot et Cowork. Ce chiffre correspond à des charges spécifiques et ne doit pas être confondu avec la comparaison entre Maia 300 et d’autres systèmes par mégawatt.
Le déploiement de Maia 300 débutera en 2027. La société prévoit également d’étendre la famille Maia à plusieurs gigawatts à partir de cette date, bien que l’annonce ne précise pas le calendrier exact ni la répartition régionale des capacités prévues.
Cela ne signifie pas que tous les services de Microsoft abandonneront les GPU d’autres fabricants. L’objectif affiché est de faire de Maia le système principal pour l’inférence de ses produits et services, sans nécessairement remplacer complètement les accélérateurs externes.
Pour les clients Azure, le développement de Maia pourrait offrir davantage d’options d’infrastructure pour exécuter des modèles et applications IA. L’impact sur les prix, la disponibilité ou la performance dépendra de la façon dont Microsoft déploiera ses nouveaux systèmes et des conditions commerciales qu’elle proposera.
Questions fréquemment posées
Quand Microsoft lancera-t-il Maia 300 ?
Microsoft prévoit de commencer le déploiement en production de Maia 300 en 2027. La date de disponibilité générale pour les clients n’a pas encore été communiquée.
Quelle mémoire et bande passante comporte Maia 300 ?
Chaque accélérateur possède 288 Go de mémoire HBM4 et atteint jusqu’à 18 To/s de bande passante. Un rack complet avec 96 accélérateurs totalise 27,6 To de mémoire HBM.
Quel procédé de fabrication utilise Maia 300 ?
Les chiplets de calcul utilisent le procédé N2P de TSMC. Le design sépare les fonctions de calcul, de contrôle mémoire et d’entrées/sorties dans différents chiplets.
Quelle différence entre Maia 200 et Maia 300 ?
Maia 200 est déjà en production pour des charges internes chez Microsoft, tandis que Maia 300 est conçu pour optimiser l’inférence de tâches à forte demande mémoire et contexte étendu. Microsoft affirme que Maia 300 peut atteindre jusqu’à sept fois plus de tokens par rack que Maia 200 dans une configuration de 96 accélérateurs.