AM Intelligence a commandé 20 000 GPU Nvidia Rubin supplémentaires pour renforcer son infrastructure d’intelligence artificielle en Inde et en Malaisie. Cette nouvelle commande représente environ 70 MW de capacité et porte le total des GPU Rubin engagés par l’entreprise pour ses premières installations d’IA à près de 29 000, avec des livraisons prévues à partir de 2027.
Les points clés d’AM Intelligence et Nvidia Rubin en 20 secondes
- AM Intelligence a commandé 20 000 GPU Nvidia Rubin additionnels pour l’Inde et la Malaisie.
- Ces nouveaux systèmes représentent environ 70 MW de capacité de calcul.
- Avec les commandes précédentes, l’entreprise a engagé près de 29 000 GPU Rubin.
- Le premier déploiement à Hyderabad comprend 9 000 GPU et 30 MW.
- AM Intelligence prévoit de constituer un portefeuille mondial d’environ 400 MW de capacité d’IA.
Cette annonce prolonge un engagement amorcé dès août, avec une commande initiale de 9 000 GPU Nvidia Rubin pour une première usine d’IA à Hyderabad. Cette installation, initialement conçue pour 30 MW, devrait recevoir ses accélérateurs au premier trimestre 2027.
Les 20 000 GPU additionnels seront répartis entre l’Inde et la Malaisie. Leur livraison est escomptée pour le deuxième trimestre 2027, ils ne font donc pas encore partie d’une capacité opérationnelle. Il s’agit d’une infrastructure réservée aux déploiements futurs.
AM Intelligence souhaite déployer l’infrastructure Rubin en Asie
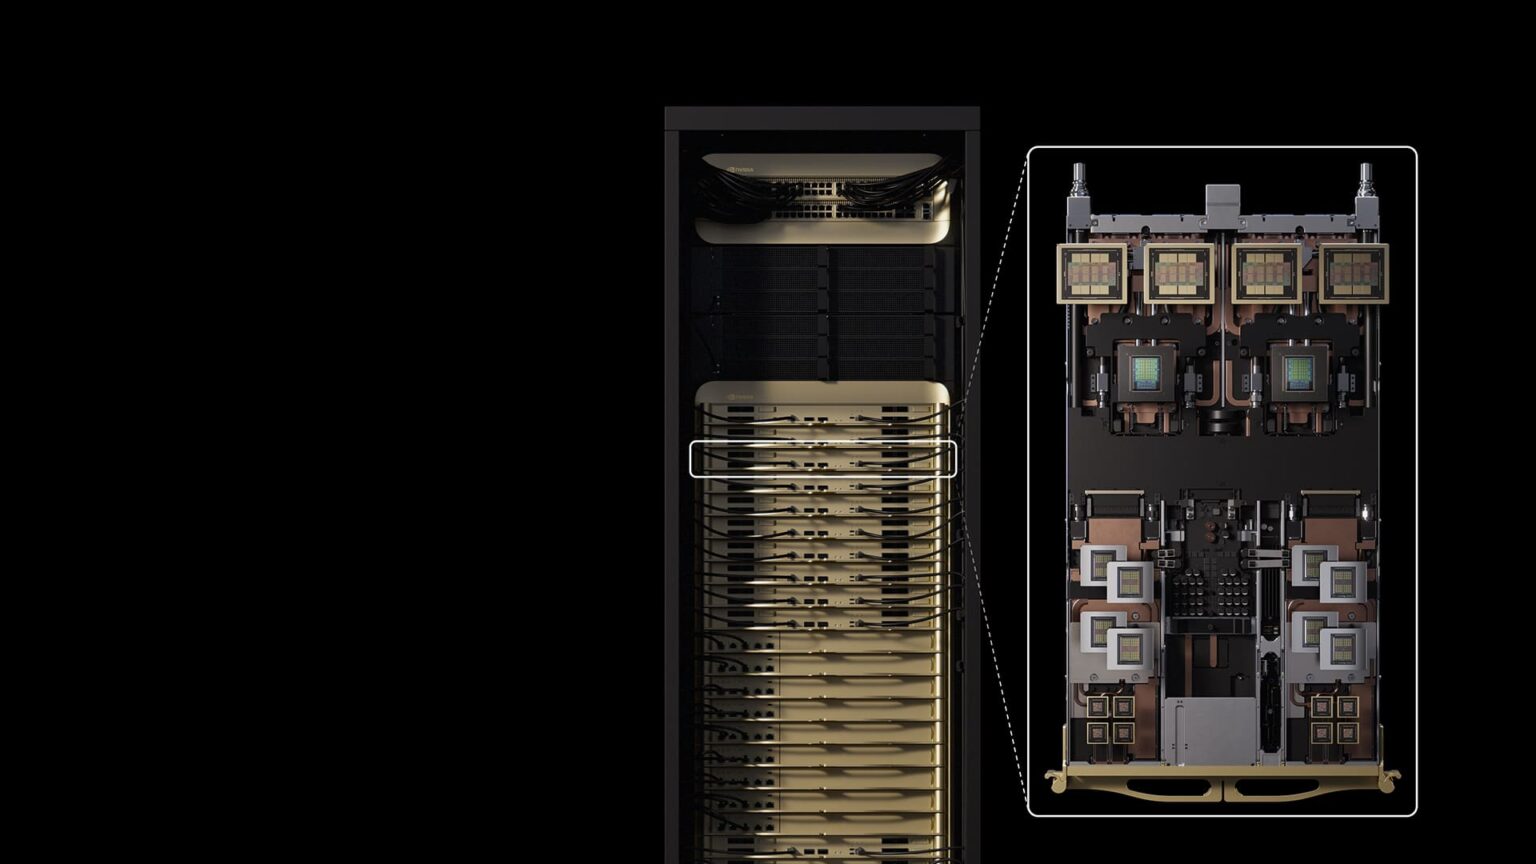
Les nouveaux systèmes seront basés sur Nvidia Vera Rubin NVL72, une plateforme conçue pour assembler les accélérateurs dans des racks à haute densité. Chaque système intègre 72 GPU Rubin, 36 CPU Vera, ainsi que l’infrastructure réseau et d’interconnexion nécessaire pour relier tous les composants.
Nvidia a conçu cette génération pour des charges d’intelligence artificielle à grande échelle, aussi bien pour l’entraînement que pour l’inférence. La plateforme combine GPU, NVLink, réseaux haute vitesse, mémoire et stockage afin de constituer une infrastructure intégrée.
Pour AM Intelligence, l’enjeu ne se limite pas à l’achat de GPU. La société construit des installations conçues pour supporter une densité élevée de calcul, avec refroidissement liquide et réseaux à très haute vitesse. L’objectif est d’offrir des capacités de calcul à des fournisseurs cloud, entreprises et développeurs, qui ont besoin de charger leurs modèles d’IA.
Ce choix est stratégique car un projet de plusieurs milliers de GPU nécessite une infrastructure robuste : alimentation électrique, refroidissement, réseaux, stockage et espace physique doivent être dimensionnés pour fonctionner de concert.
Pour ces commandes, AM Intelligence estime une consommation supplémentaire d’environ 70 MW. En ajoutant les 30 MW prévus pour Hyderabad, les commandes annoncées avoisinent désormais les 100 MW de capacité.
L’Inde recherche une capacité de calcul supplémentaire pour l’IA
Ce déploiement s’inscrit dans le développement de l’infrastructure d’IA en Inde. Le pays augmente ses capacités locales de calcul alors que les entreprises technologiques et les fournisseurs de services recherchent un accès à un grand nombre d’accélérateurs.
Hyderabad sera l’un des premiers sites d’AM Intelligence. La société présente cette installation comme l’une des premières usines d’IA en Asie basée sur Nvidia Vera Rubin, avec une mise en service progressive prévue tout au long de 2027.
Le projet s’appuie également sur l’infrastructure énergétique locale. Pour des centres de données à haute densité, l’électricité et la capacité de refroidissement sont aussi cruciales que le nombre de GPU installés.
AM Intelligence envisage ses centres comme des infrastructures de calcul disponibles également pour des tiers. Ce modèle permettrait à des entreprises ne souhaitant pas construire leur propre centre de données de louer de la capacité GPU afin de former des modèles, réaliser des inférences ou développer des applications d’IA.
Une partie de ces nouveaux accélérateurs sera également déployée en Malaisie. Le pays devient l’un des marchés asiatiques attirant investissements dans les centres de données et les services liés à l’IA.
29 000 GPU Rubin engagés et un portefeuille bien plus ambitieux
Avec ces 20 000 GPU supplémentaires, AM Intelligence porte à environ 29 000 le total des GPU Rubin engagés jusqu’à présent. Ce chiffre résulte de l’addition des 9 000 GPU initialement destinés à Hyderabad et des 20 000 nouveaux commandes pour l’Inde et la Malaisie.
Par ailleurs, l’entreprise annonce disposer d’un portefeuille mondial d’environ 400 MW de capacité en Compute-as-a-Service. Ce portefeuille inclut des projets en Inde, aux États-Unis, en Europe et en Malaisie. Cependant, cela ne signifie pas que cette capacité est déjà entièrement construite ou opérationnelle.
AM Intelligence prévoit également de mettre sur le marché 300 MW supplémentaires de capacité de calcul dans les 15 prochains mois. La société indique investir plus de 20 milliards de dollars dans ce développement, en plus des 6 milliards déjà engagés pour ses premiers 100 MW.
L’objectif à plus long terme est de disposer d’environ 1 GW de capacité globale en Compute-as-a-Service, ainsi que de centres de données pouvant soutenir jusqu’à 5 GW d’alimentation électrique adaptée aux charges d’IA. Ces projets dépendent de la construction des installations, de l’approvisionnement en accélérateurs et de la disponibilité énergétique.
Le calendrier de Nvidia explique en partie pourquoi ces achats importants sont conclus avant la disponibilité opérationnelle complète. Rubin représente l’évolution suivante des accélérateurs de la société, conçus pour que plusieurs centaines ou milliers de GPU fonctionnent ensemble comme un seul système de calcul.
Rubin transforme le centre de données en système intégré
L’architecture Vera Rubin NVL72 illustre l’évolution dans la conception des centres de données pour l’IA. Au lieu de considérer chaque GPU comme un composant indépendant, Nvidia assemble accélérateurs, CPU, mémoire et réseaux dans des systèmes complets.
Nvidia affiche des performances très élevées pour cette plateforme, mais ces chiffres sont basés sur des configurations spécifiques. En pratique, le rendement final dépendra également de la configuration du centre, du logiciel, du réseau et des charges exécutées.
Pour AM Intelligence, le défi sera de transformer ces commandes en infrastructures capables de fournir cette capacité aux clients. Les premiers 9 000 GPU de Hyderabad devraient être opérationnels au premier trimestre 2027, suivis par les 20 000 autres dans le trimestre suivant.
Cela fait de 2027 une année clé pour évaluer la part réelle de cette capacité déployée. Jusqu’alors, les 29 000 GPU ne sont que des commandes et engagements d’infrastructure, pas encore des accélérateurs en service simultané.
Ce mouvement illustre également l’évolution de la course à l’infrastructure IA. La compétition ne consiste plus simplement à obtenir suffisamment de GPU, mais aussi à disposer simultanément d’électricité, refroidissement, réseaux, stockage et espace pour héberger des systèmes de plus en plus densément configurés.
L’Inde et la Malaisie se positionnent ainsi comme deux marchés où cette nouvelle génération de centres de données se développe. AM Intelligence tente de prendre une longueur d’avance avec une infrastructure basée sur Rubin et une capacité globale potentielle nettement supérieure aux premiers 100 MW actuellement engagés.
Questions fréquentes
Combien de GPU Nvidia Rubin AM Intelligence a-t-elle commandé ?
AM Intelligence a engagé environ 29 000 GPU Rubin, après avoir additionné la commande initiale de 9 000 accélérateurs et les 20 000 annoncés par la suite.
Où seront installés les nouveaux GPU Rubin ?
Les 20 000 nouveaux GPU seront destinés à des installations d’IA en Inde et en Malaisie. Le premier projet annoncé se situe à Hyderabad.
Quand AM Intelligence réceptionnera-t-elle les GPU Rubin ?
Les 9 000 GPU destinés à Hyderabad devraient arriver au premier trimestre 2027. Les autres 20 000 accélérateurs sont prévus pour le deuxième trimestre 2027.
Quelle capacité d’infrastructure IA AM Intelligence prévoit-elle ?
La société indique disposer d’un portefeuille mondial d’environ 400 MW en Compute-as-a-Service, avec un projet d’ajouter 300 MW dans les 15 prochains mois. Ces chiffres représentent des plans et capacités projetés, non encore entièrement opérationnels.