D-Matrix connectera ses puces d’IA à l’infrastructure NVIDIA avec NVLink Fusion
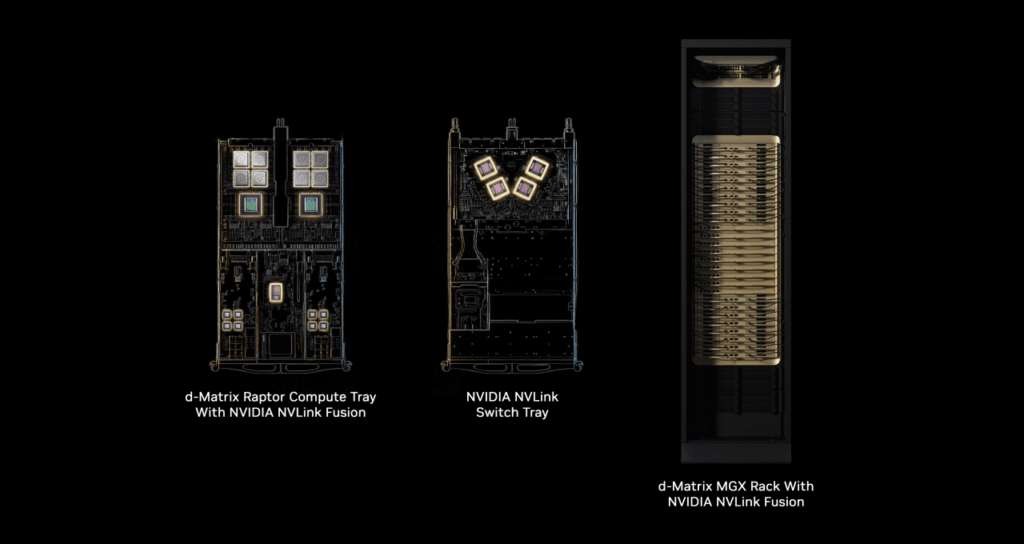
d-Matrix intégrera sa prochaine génération d’accélérateurs d’intelligence artificielle, le Raptor XPU, dans l’architecture de racks NVIDIA MGX via NVLink Fusion. Cette coopération pluriannuelle vise à déployer ces puces spécialisées en inférence dans de grands centres de données sans avoir à développer une infrastructure complète dès le départ. Les premiers systèmes intégrés sont prévus pour le […]
D-Matrix empile la DRAM sur la puce et vise 100 To/s en inférence IA
d-Matrix a présenté lors de Hot Chips 2026 de nouveaux détails sur Raptor, sa prochaine génération d’accélérateurs pour l’inférence en intelligence artificielle, bâtie sur une architecture peu conventionnelle : intégrer la puce de calcul directement sur une DRAM conçue sur mesure. Le résultat promis atteint jusqu’à 100 To/s de bande passante par carte avec 32 […]
d-Matrix introduit la DRAM en 3D pour attaquer le mur de mémoire de l’IA
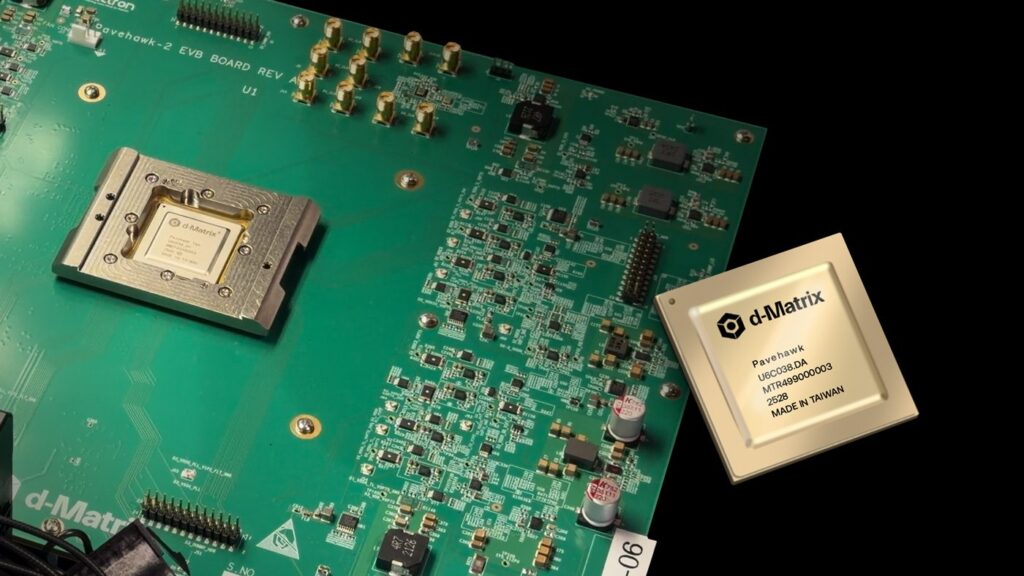
La course à l’accélération de l’intelligence artificielle ne dépend plus uniquement de la fabrication de GPU plus puissants. d-Matrix a détaillé Raptor, sa prochaine architecture pour l’inférence, qui utilisera de la mémoire DRAM empilée directement avec la logique pour atteindre jusqu’à 100 TB/s de bande passante avec 32 Go de capacité, selon les spécifications présentées […]
D-Matrix présente 3DIMC : la mémoire 3D empilée qui veut détrôner HBM dans l’inférence d’IA
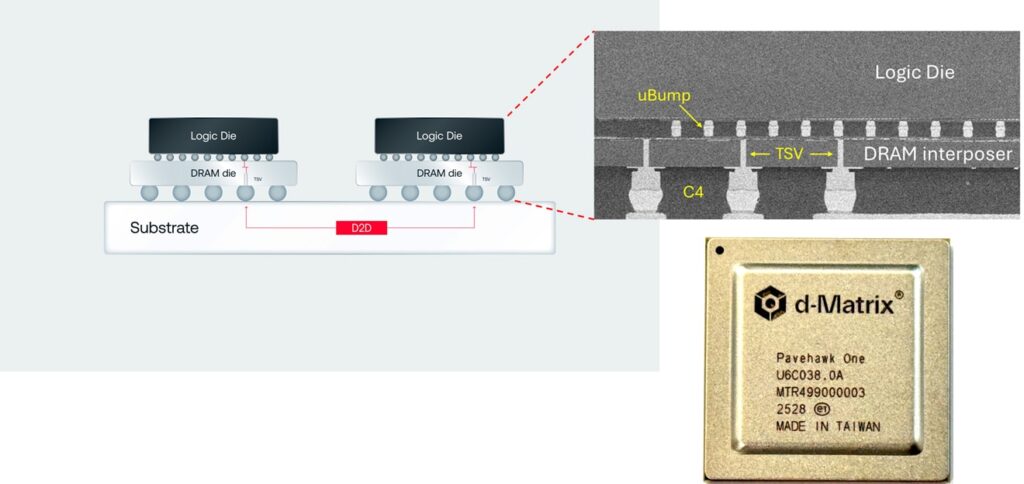
La startup affirme que sa technologie sera jusqu’à 10 fois plus rapide et efficace que la mémoire HBM pour les charges d’inférence, marquant ainsi un changement de paradigme dans la relation entre calcul et mémoire. La mémoire à large bande passante (HBM) est devenue la référence incontournable en intelligence artificielle et calcul haute performance. Utilisée […]