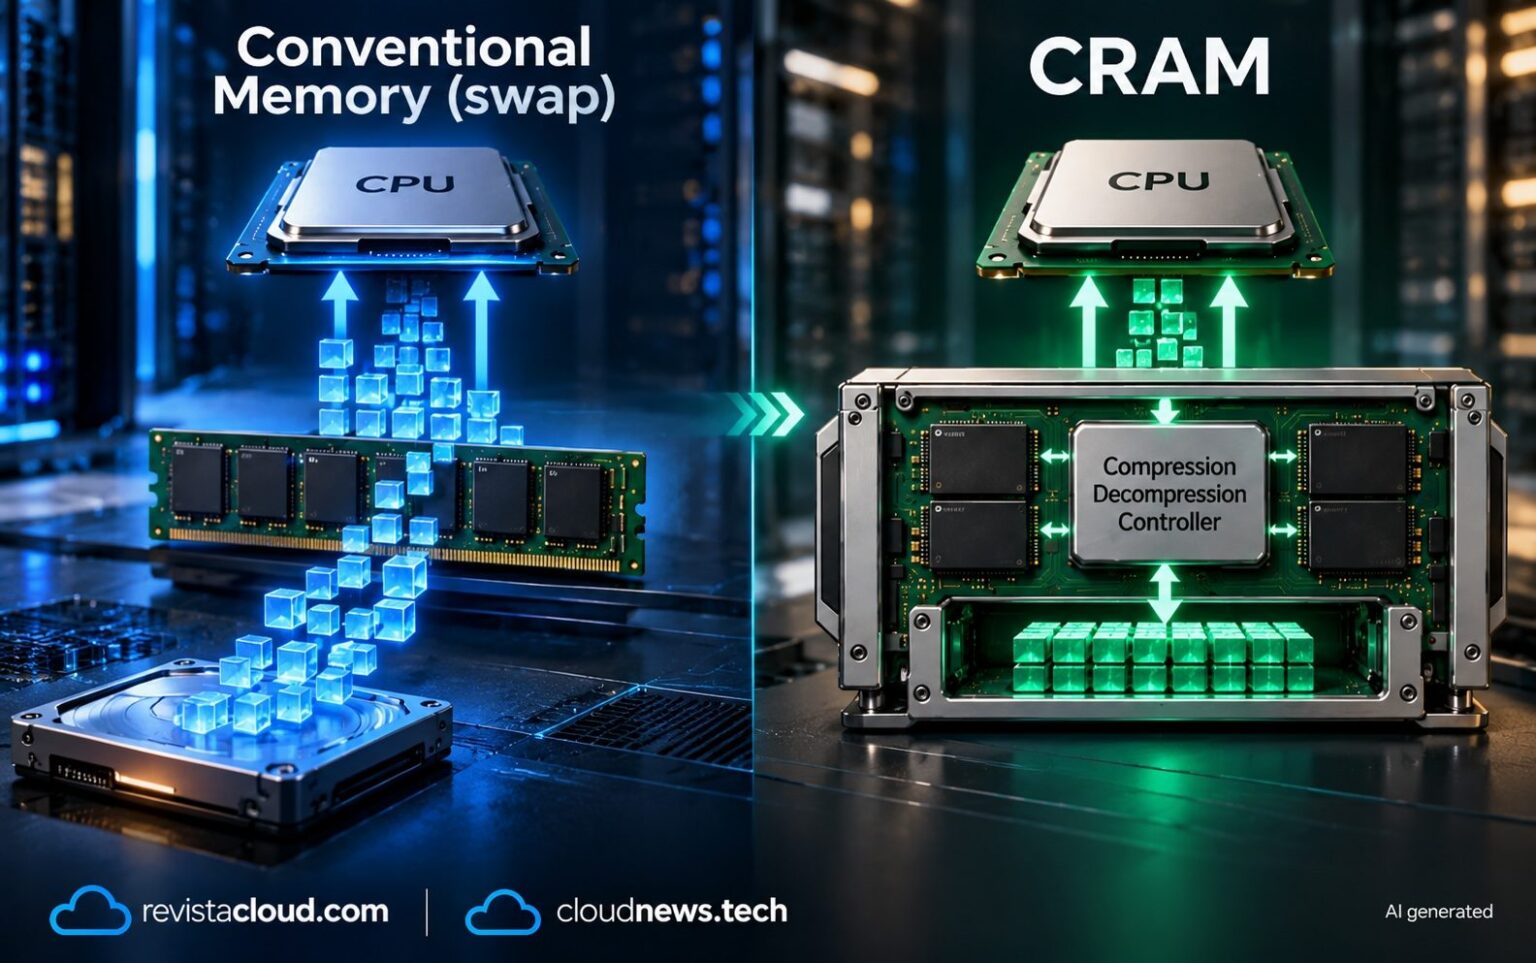
CRAM propose une nouvelle manière d’exploiter la mémoire des serveurs : maintenir des pages en mémoire compressée et permettre au processeur d’y accéder directement via du matériel spécialisé, sans que Linux ait besoin de récupérer et de décompresser chaque page avant utilisation. La présentation, faite par Gregory Price de Meta lors de la Linux Plumbers Conference, vise à dépasser certaines limitations des solutions logicielles actuelles comme zram et zswap.
Les points clés de CRAM en 30 secondes
- CRAM introduit une mémoire compressée accessible directement par le processeur grâce à un contrôleur de compression/décompression intégré au matériel.
- Contrairement à zram et zswap, son objectif est d’éviter que Linux doive reconstruire une page en mémoire ordinaire avant de l’utiliser pour une lecture.
- La solution envisage de transférer les pages vers la DRAM classique lorsque leur modification nécessite de les écrire.
- Les tests présentés ont montré jusqu’à 452 fois plus de débit en lecture par rapport à zram dans un scénario conçu pour isoler certains coûts.
- Cette approche pourrait améliorer l’utilisation de la mémoire physique des serveurs, mais nécessite du matériel spécifique et n’est pas encore une solution commerciale généralisée.
L’intérêt pour CRAM croît à un moment où le coût de la mémoire inquiète les opérateurs de centres de données. Si un serveur peut stocker plus d’informations avec la même quantité de RAM physique sans pénaliser excessivement les lectures, cela pourrait réduire la pression pour augmenter la mémoire installée. Cependant, son efficacité dépendra de ses performances en conditions réelles et de la capacité des fabricants à développer du matériel compatible.
Pourquoi zram et zswap ne résolvent pas le même problème
Linux dispose déjà de mécanismes pour réduire la consommation de mémoire physique, notamment zram et zswap, bien que leur fonctionnement diffère.
zram crée un dispositif de blocs en RAM supportant des données compressées, souvent utilisé comme espace d’échange (swap). Lorsqu’une page stockée y doit être récupérée, le système doit la reconstruire pour qu’elle soit exploitable.
zswap agit comme un cache compressé placé en amont d’un espace d’échange réel. Il conserve temporairement des pages compressées en mémoire et peut réduire les opérations de lecture/écriture vers le stockage secondaire. Lorsqu’il doit libérer de l’espace, les données peuvent migrer vers l’espace d’échange classique.
Les deux mécanismes améliorent l’efficacité de la mémoire, mais continuent de dépendre du système d’exploitation pour gérer la récupération des données. Lorsqu’une application demande une page absente de la mémoire active, Linux doit gérer un défaut de page, récupérer son contenu et le décompresser via logiciel.
Ce processus ajoute une étape avant que l’application ne puisse continuer, dont le coût dépend de plusieurs facteurs : l’algorithme de compression, la charge de travail, et la localisation des données.
CRAM vise précisément à changer cette donne. Sa proposition ne se limite pas à compresser davantage de pages, mais à permettre au processeur de lire directement des données stockées dans une mémoire compressée, sans que Linux ait besoin de les reconstruire dans la DRAM classique.
CRAM nécessite du matériel capable de lire des données compressées
Le concept place les fonctions de compression et de décompression dans un contrôleur hardware dédié à la mémoire. Les pages restent compressées dans le dispositif, et le contrôleur fournit les données décompressées lorsque le processeur en fait la demande.
Pour l’application, l’objectif est de conserver un accès via des adresses mémoire normales. La complexité est principalement gérée par l’infrastructure qui stocke les données compressées et gère leur transfert.
Cette approche modifie la donne, car la compression n’est plus une opération que le système d’exploitation doit exécuter avant chaque récupération. Sur certains charges, notamment lorsque les données sont lues fréquemment mais peu modifiées, cela pourrait réduire la surcharge associée à la gestion de la mémoire.
Toutefois, cette proposition ne supprime pas le travail du noyau Linux. Ce dernier doit encore gérer la localisation des pages, leur protection, la récupération de la mémoire disponible, la migration des données, et décider quelles pages restent compressées et lesquelles retournent dans la mémoire standard.
Il existe aussi une limite physique : les données compressées n’occupent pas toujours moins d’espace. Une page de 4 Ko pourrait se réduire à 1 Ko avec une compression efficace, mais si le contenu est peu compressible, elle pourrait conserver presque sa taille originelle.
Les écritures complicent aussi la gestion. Si une page compressée de 1 Ko doit être modifiée et que ses données deviennent proches de 4 Ko, le dispositif doit gérer cette migration. L’approche envisage de laisser les pages compressées en mode lecture seule, toute écriture provoquant leur migration vers la DRAM classique avant modification.
Ce comportement est avantageux essentiellement pour les charges dominées par la lecture, mais dépendra du ratio entre lectures et écritures, de la compressibilité des données, et de la fréquence de migration des pages.
Une amélioration potentielle de 452 fois doit être contextualisée
Une statistique frappante liée à CRAM est une amélioration pouvant atteindre 452 fois le débit de lecture par rapport à zram. Cependant, cela ne signifie pas que l’ensemble d’une application s’exécutera 452 fois plus vite.
Ce résultat a été obtenu dans un environnement simulant la mémoire DRAM en reproduisant le comportement d’un futur dispositif de mémoire compressée. L’objectif était d’isoler la surcharge liée aux défauts de page et à la décompression logicielle, pour évaluer les avantages potentiels d’une lecture directe depuis des pages compressées.
Il s’agit d’une distinction importante. Un bon résultat en lecture dans un test spécifique ne peut pas être extrapolé à la performance globale d’un serveur, d’une base de données ou d’une application. Pour mesurer le vrai impact, il faudrait des tests avec du matériel réel, différentes charges de travail, et analyser à la fois lectures et écritures, en tenant compte du coût de la gestion mémoire.
De plus, cette solution nécessite une infrastructure permettant d’exposer la mémoire compressée comme un espace accessible directement. La technologie Compute Express Link (CXL), qui connecte processeurs, mémoire et autres accélérateurs, apparaît comme une voie pour explorer ce type de design. Mais cela ne signifie pas que tous les dispositifs CXL actuels intégreraient CRAM, ni que cette technologie soit déjà disponible à grande échelle.
L’augmentation des coûts et la pénurie de RAM pourraient accroître l’intérêt pour cette approche. Dans les centres de données, mieux exploiter la mémoire installée pourrait limiter la nécessité d’augmenter la capacité physique. Toutefois, les bénéfices potentiels doivent compenser le coût du matériel, la complexité d’intégration, et la nature des charges de travail.
Pour l’instant, CRAM se présente comme une proposition d’architecture permettant d’étudier une utilisation plus directe de la mémoire compressée. Les tests en DRAM aident à valider le concept, mais la performance dans des dispositifs conçus à cet effet reste à démontrer.
Questions fréquentes
Qu’est-ce que CRAM en Linux ?
CRAM est une proposition de mémoire compressée accessible directement via du matériel spécialisé. Son objectif est de permettre au processeur de lire des données compressées sans que Linux doit d’abord récupérer chaque page dans la DRAM classique, puis la décompresser par logiciel.
En quoi CRAM diffère-t-il de zram et zswap ?
zram fournit un dispositif de blocs alimenté en RAM, souvent utilisé comme espace d’échange. zswap agit comme un cache compressé placé en amont d’un espace d’échange classique, conservant temporairement des pages compressées en mémoire. CRAM propose un accès direct matériel aux données compressées, avec un modèle opérationnel différent.
CRAM permet-il d’accélérer les applications de 452 fois ?
Non. La valeur mentionnée correspond à une amélioration du débit de lecture dans un test spécifique destiné à isoler certains coûts par rapport à zram. Elle ne reflète pas une augmentation équivalente de la vitesse des applications ou de la performance globale d’un serveur.
CRAM est-il utilisable sur n’importe quel serveur aujourd’hui ?
La solution requiert du matériel spécifique capable de gérer et d’exposer la mémoire compressée directement. Les tests impliquant la DRAM permettent d’étudier le concept, mais cela ne signifie pas qu’une solution commerciale généraliste existe déjà pour tous les serveurs.