Catégorie : Cloud

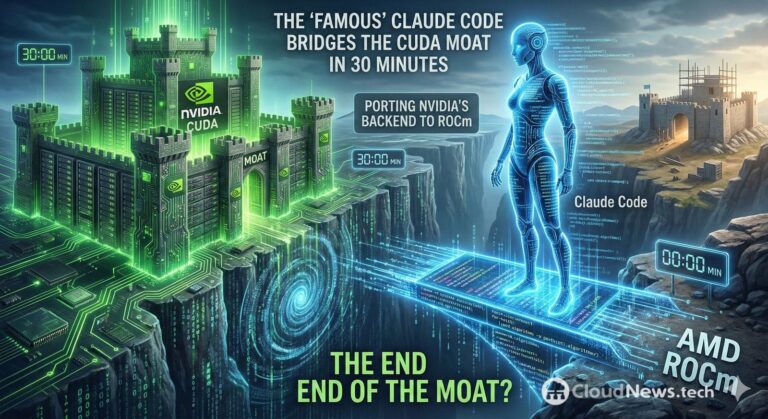
Claude Code et la « muraille » de CUDA : une migration vers ROCm en 30 minutes relance le débat sur l’enfermement de NVIDIA

Claude Code et la « muraille » de CUDA : une migration vers ROCm en 30 minutes relance le débat sur l’enfermement de NVIDIA

Une discussion sur Reddit a ravivé un débat qui mijotait depuis des mois dans la communauté GPU : dans quelle mesure la « muraille » de CUDA — combinant API, bibliothèques, outils et expérience accumulée autour de NVIDIA — reste une barrière réelle si les outils de programmation assistée par agents commencent à automatiser le travail ardu de portage. Le point de départ de cette polémique est une affirmation aussi directe que polémique : un utilisateur affirme avoir porté un backend CUDA complet vers ROCm en une trentaine de minutes grâce à Claude Code, l’environnement de codage assisté d’Anthropic, sans recourir à des couches de traduction « intermédiaires » type wrapper, et avec un seul obstacle majeur : les différences
Samsung accélère son HBM « sur mesure » et entre dans la phase backend du base die de HBM4E

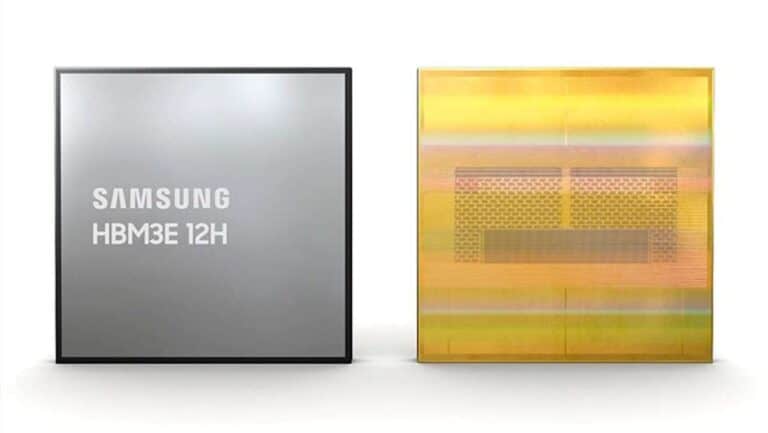
Samsung accélère son HBM « sur mesure » et entre dans la phase backend du base die de HBM4E

Samsung Electronics a franchi une étape importante dans sa feuille de route pour la mémoire à large bande passante : la société a entamé la phase de conception backend de son base die personnalisé pour la HBM4E (7e génération), un jalon qui, dans le développement de silicium, est généralement interprété comme ayant dépassé la « moitié du chemin » vers le tape-out. Le point central concerne une composante de plus en plus cruciale dans la compétition pour la fourniture de mémoire pour l’intelligence artificielle : le base die, le « substrat logique » situé à la base du stack HBM. Sur un marché où les clients exigent désormais non seulement capacité et bande passante, mais aussi fonctions logiques spécifiques intégrées

Le marché mondial des puces IA connaîtra une croissance significative jusqu'en 2029

2026 s’annonce comme l’« année de l’ASIC » dans le cloud, mais la mémoire pourrait freiner le déploiement

La course à la réduction des coûts et à l’extension de la puissance de calcul pour l’intelligence artificielle pousse les principaux fournisseurs de services cloud — et leur écosystème de partenaires — vers une nouvelle phase : plus de racks avec des accélérateurs sur mesure (ASIC) et une dépendance moindre aux hardware standards. La logique est claire : lorsque les volumes d’inférence augmentent, l’efficacité par euro et par watt devient prioritaire ; et dans ce contexte, les conceptions spécifiques (TPU, chips intégrés, accélérateurs personnalisés) gagnent en attractivité face aux solutions généralistes. Dans ce contexte, plusieurs sources du secteur annoncent un fort rebond des livraisons d’ASIC pour le cloud en 2026, avec Broadcom remportant de grands projets de production avec plusieurs

UltraRAM : la mémoire qui promet de combiner stockage et RAM en une seule puce

TrendForce avertit : la mémoire devient le nouveau goulot d’étranglement de l’ère de l’IA et prévoit un pic historique en 2027

La narration dominante concernant l’infrastructure pour l’intelligence artificielle tourne généralement autour des GPU, des interconnexions et des centres de données. Pourtant, un rapport récent de TrendForce met en lumière un composant qui, discrètement, influence les coûts, la performance et la planification de la capacité : la mémoire. Selon ses prévisions, l’évolution des architectures d’IA — de plus en plus orientées vers une inference soutenue, de grands volumes de données et un accès aléatoire — pousse le marché combiné de la DRAM et de la mémoire NAND flash vers un sommet historique prévu pour 2027, avec des rythmes de croissance évoquant une « seconde vague » du boom de l’IA, mais cette fois, avec la mémoire en vedette. Un saut d’échelle

NVMe 2.3 renforce la sécurité et le contrôle des données dans les SSD : voici ses 10 principales nouveautés

Intel cherche à exploiter NVMe sur Linux : un correctif « compatible avec les clusters » promet jusqu’à 15 % de plus sur les systèmes multi-cœurs

Dans le domaine de la performance, ce ne sont pas toujours les réécritures majeures qui la boostent. Parfois, le saut intervient grâce à un détail apparemment mineur : où se concentrent les “interruptions”. C’est précisément là qu’ingénieurs de chez Intel s’attellent à modifier le noyau Linux pour optimiser la gestion du stockage NVMe sur des serveurs modernes dotés d’un grand nombre de cœurs. Le problème survient lorsque le nombre d’IRQ NVMe est inférieur au nombre de CPU, ce qui est courant dans les architectures actuelles. Dans ce cas, plusieurs cœurs partagent une même interruption, et si l’affinité de cette IRQ n’est pas bien alignée avec la topologie réelle du processeur, cela engendre une augmentation de la latence et une baisse

La « panne informatique » cesse d'être une anecdote : la PME technologique espagnole la considère désormais comme un risque de continuité

La « panne informatique » cesse d’être une anecdote : la PME technologique espagnole la considère désormais comme un risque de continuité

Depuis plusieurs années, le concept d’“arrêt total numérique” était associé à des scénarios extrêmes : des défaillances massives peu probables, des incidents que “d’autres” subissent ou des problèmes ponctuels résolubles par un simple redémarrage et un peu de patience. Ce cadre mental est en train de changer. Selon le Baromètre Tech 2025 : photographie de la PME technologique espagnole, réalisé par Hiscox, 81 % des PME technologiques en Espagne considèrent qu’un arrêt informatique représente une menace sérieuse pour leur activité. En bref : la coupure des services numériques — qu’elle soit due à une panne d’infrastructure, à des interruptions dans le cloud ou à des incidents impliquant des tiers — doit désormais être considérée au même titre que les risques

Claude Code et la « muraille » de CUDA : une migration vers ROCm en 30 minutes relance le débat sur l’enfermement de NVIDIA

Claude Code et la « muraille » de CUDA : une migration vers ROCm en 30 minutes relance le débat sur l’enfermement de NVIDIA

Une discussion sur Reddit a ravivé un débat qui mijotait depuis des mois dans la communauté GPU : dans quelle mesure la « muraille » de CUDA — combinant API, bibliothèques, outils et expérience accumulée autour de NVIDIA — reste une barrière réelle si les outils de programmation assistée par agents commencent à automatiser le travail ardu de portage. Le point de départ de cette polémique est une affirmation aussi directe que polémique : un utilisateur affirme avoir porté un backend CUDA complet vers ROCm en une trentaine de minutes grâce à Claude Code, l’environnement de codage assisté d’Anthropic, sans recourir à des couches de traduction « intermédiaires » type wrapper, et avec un seul obstacle majeur : les différences
Samsung accélère son HBM « sur mesure » et entre dans la phase backend du base die de HBM4E

Samsung accélère son HBM « sur mesure » et entre dans la phase backend du base die de HBM4E

Samsung Electronics a franchi une étape importante dans sa feuille de route pour la mémoire à large bande passante : la société a entamé la phase de conception backend de son base die personnalisé pour la HBM4E (7e génération), un jalon qui, dans le développement de silicium, est généralement interprété comme ayant dépassé la « moitié du chemin » vers le tape-out. Le point central concerne une composante de plus en plus cruciale dans la compétition pour la fourniture de mémoire pour l’intelligence artificielle : le base die, le « substrat logique » situé à la base du stack HBM. Sur un marché où les clients exigent désormais non seulement capacité et bande passante, mais aussi fonctions logiques spécifiques intégrées

Le marché mondial des puces IA connaîtra une croissance significative jusqu'en 2029

2026 s’annonce comme l’« année de l’ASIC » dans le cloud, mais la mémoire pourrait freiner le déploiement

La course à la réduction des coûts et à l’extension de la puissance de calcul pour l’intelligence artificielle pousse les principaux fournisseurs de services cloud — et leur écosystème de partenaires — vers une nouvelle phase : plus de racks avec des accélérateurs sur mesure (ASIC) et une dépendance moindre aux hardware standards. La logique est claire : lorsque les volumes d’inférence augmentent, l’efficacité par euro et par watt devient prioritaire ; et dans ce contexte, les conceptions spécifiques (TPU, chips intégrés, accélérateurs personnalisés) gagnent en attractivité face aux solutions généralistes. Dans ce contexte, plusieurs sources du secteur annoncent un fort rebond des livraisons d’ASIC pour le cloud en 2026, avec Broadcom remportant de grands projets de production avec plusieurs

UltraRAM : la mémoire qui promet de combiner stockage et RAM en une seule puce

TrendForce avertit : la mémoire devient le nouveau goulot d’étranglement de l’ère de l’IA et prévoit un pic historique en 2027

La narration dominante concernant l’infrastructure pour l’intelligence artificielle tourne généralement autour des GPU, des interconnexions et des centres de données. Pourtant, un rapport récent de TrendForce met en lumière un composant qui, discrètement, influence les coûts, la performance et la planification de la capacité : la mémoire. Selon ses prévisions, l’évolution des architectures d’IA — de plus en plus orientées vers une inference soutenue, de grands volumes de données et un accès aléatoire — pousse le marché combiné de la DRAM et de la mémoire NAND flash vers un sommet historique prévu pour 2027, avec des rythmes de croissance évoquant une « seconde vague » du boom de l’IA, mais cette fois, avec la mémoire en vedette. Un saut d’échelle

NVMe 2.3 renforce la sécurité et le contrôle des données dans les SSD : voici ses 10 principales nouveautés

Intel cherche à exploiter NVMe sur Linux : un correctif « compatible avec les clusters » promet jusqu’à 15 % de plus sur les systèmes multi-cœurs

Dans le domaine de la performance, ce ne sont pas toujours les réécritures majeures qui la boostent. Parfois, le saut intervient grâce à un détail apparemment mineur : où se concentrent les “interruptions”. C’est précisément là qu’ingénieurs de chez Intel s’attellent à modifier le noyau Linux pour optimiser la gestion du stockage NVMe sur des serveurs modernes dotés d’un grand nombre de cœurs. Le problème survient lorsque le nombre d’IRQ NVMe est inférieur au nombre de CPU, ce qui est courant dans les architectures actuelles. Dans ce cas, plusieurs cœurs partagent une même interruption, et si l’affinité de cette IRQ n’est pas bien alignée avec la topologie réelle du processeur, cela engendre une augmentation de la latence et une baisse

La « panne informatique » cesse d'être une anecdote : la PME technologique espagnole la considère désormais comme un risque de continuité

La « panne informatique » cesse d’être une anecdote : la PME technologique espagnole la considère désormais comme un risque de continuité

Depuis plusieurs années, le concept d’“arrêt total numérique” était associé à des scénarios extrêmes : des défaillances massives peu probables, des incidents que “d’autres” subissent ou des problèmes ponctuels résolubles par un simple redémarrage et un peu de patience. Ce cadre mental est en train de changer. Selon le Baromètre Tech 2025 : photographie de la PME technologique espagnole, réalisé par Hiscox, 81 % des PME technologiques en Espagne considèrent qu’un arrêt informatique représente une menace sérieuse pour leur activité. En bref : la coupure des services numériques — qu’elle soit due à une panne d’infrastructure, à des interruptions dans le cloud ou à des incidents impliquant des tiers — doit désormais être considérée au même titre que les risques